toge's diary

コンピュータ関連の趣味をつらつらと。

C++でCSVを読むライブラリ選定 (2026年版)

2026年になってもC++でCSVを処理したくなる機会は思いのほか多いです。 ログ解析、バッチ変換、設定読み込み……。 個人的には最近業務が変わって膨大なアイテム情報が記載されたCSVファイルの処理に直面してたりします。

こんな時にライブラリを選ぼうとすると「どれが速いのか」「multilineに対応しているか」「余分な列はどう扱うか」といった疑問が次々と出てきます。

そこで2026年現在の主要C++ CSVライブラリを整理して vincentlaucsb/csv-parser と stephenberry/glaze の2択に絞り込み、実測ベンチマークを通じてユースケースごとの使い分けを示します。

C++でCSVを扱う際の要件

今回のライブラリ選定は以下の4要件を満たすことを基準としました。

  1. 単スレッドでも高速に動かしたい マルチスレッドが使えない環境(Emscripten/WASM等)や他処理の負荷が高い環境で安定して高速動作させたい
  2. multiline(フィールド内改行)に対応したい
  3. ヘッダなしCSVに後から列名を付与したい
  4. 指定列以降の余り列の不一致や過剰をエラーにせず無視したい

主要ライブラリの比較

2026年時点で開発が継続されているように見える主要C++ CSVライブラリを整理します。

ライブラリ バージョン 言語標準 配布形態 ライセンス 特徴
vincentlaucsb/csv-parser v5.3.0 (2026-05) 活発 C++11-20 CMake / single_header MIT RFC4180完全準拠、multiline、SIMD+mmap、大規模ETL向け
ben-strasser/fast-cpp-csv-parser 2025年が最終更新 C++11 単一ヘッダ BSD-3 枯れて安定、I/Oとparse重畳
d99kris/rapidcsv 活発 C++11 単一ヘッダ BSD-3 読み書き両対応、APIが最も簡潔
p-ranav/csv2 活発 C++11 単一ヘッダ MIT mmap+lazy、高速
ashtum/lazycsv 活発 C++17 単一ヘッダ MIT 真のlazy、ゼロアロケーション
stephenberry/glaze v8.3.0 (2026-08) 活発 C++23 ヘッダオンリー MIT 構造体反射でCSV/JSONを統一API
Apache Arrow CSV v25 活発 C++17 ライブラリ Apache-2.0 Arrow Tableへ直接ingest、列指向パイプライン

ざっくり用途別に整理すると以下のような感じになると思います。

  • 手軽に読み書きしたい → rapidcsv
  • シングルヘッダファイルでで依存ゼロ → fast-cpp-csv-parser / csv2 / lazycsv
  • struct ↔ CSV/JSON を統一API → Glaze
  • データパイプラインの中で数GBを高速処理したい → vincentlaucsb/csv-parser
  • Arrow/Parquetと連携 → Arrow CSV

なぜ vincentlaucsb と Glaze の2択か

今回最優先にした条件は「高速で動作するCSV読み書き」です。

rapidcsv はAPIが最も簡潔ですが全行をメモリに展開するため、大きなファイルでは遅くなります。 fast-cpp-csv-parser・csv2・lazycsvはシングルヘッダファイルで簡単に使えて高速ですが、multiline非対応やヘッダ後付け・余り列の制御が弱いといった制約があります。 Arrow CSVはそもそもの目的が高速処理を行うことにあるためスループットは申し分ないものの、依存が巨大で単純なCSV処理のためだけに導入するには過剰です。

速度と機能の両面から絞り込んだ結果、vincentlaucsb/csv-parser(機能の網羅性)とstephenberry/glaze(リフレクションベースの型安全なAPI)の2択となりました。

この2つを実測ベンチマークで比較することにしました。

結果を先に

もし単スレッドでの処理を想定するならば、もしくは30MB以下のファイルサイズであれば、Glazeがvincentlaucsb/csv-parserよりも高速に動作する可能性が高いです。 逆にこの条件だけがGlazeの優位性が示せるパターンになります。

余り列が存在する場合には、Glazeでは制御は難しく何もしないと失敗してしまいます。 巨大ファイルに対しては、並列処理がライブラリ内でvincentlaucsb/csv-parserの方が安定して高速に処理できます。

ライブラリの特徴

上で挙げた4要件を持ち込むと、各ライブラリの対応状況がはっきりします。

vincentlaucsb/csv-parser

機能面で最も充実しています。

  • VariableColumnPolicyによる余り列制御
  • no_header().column_names()によるヘッダ後付け
  • threading(false)によるスレッド動作の明示的な制御

今年にはいって2年ぶりぐらいに開発が再開して、大規模データの高速処理に力を入れて精力的に開発をしているのが印象的です。

具体的には次のような組み合わせのアプローチが取られています。

  • mmap でファイル読み込み
  • SIMD命令の多用
  • 並列処理の導入
  • ファイルサイズが50MBを超えるとデータ分割に効率的に対応できる投機的並列処理に移行 ref

本家README.mdの主張では、warm cacheの条件下では秒間1GByte以上の処理をCore i5-12400で実現可能としているようです。ref 秒間1Gbyteの読み込み速度はすごいですね、warm cacheでなければI/Oボトルネックになってしまう場合が多くなりそうです。

Glaze

C++23まで機能を活かしてリフレクションもどきを実現したJSONライブラリですが、実はCSVにも対応しています。 構造体(正確には集成体)とCSV/JSON/YAML/TOMLなどを統一的に扱える点が魅力です。

JSONライブラリとして長年培った技術とノウハウをCSV処理にも再利用できるためSIMD命令の利用は最低限ですが、文字列操作や型変換の最適化が効いていて、単スレッドでの速度で優位に立ちます。

ただしリフレクションベースであることが足枷になり列数が構造体フィールド数と一致しない場合に「unknown_key エラーで失敗する」という制約があります。

※ JSONでは余りのキーが存在しても無視する設定ができるのですが、CSVでは未サポートのようです。

ベンチマーク環境と方法

それでは実際にベンチマークを行ってみます。

メインPCはRyzen7 7700の環境があるのですが開発で忙しいのでサブマシンでの計測となります。ご了承ください。

条件 詳細
CPU Ryzen 7 1700
コンパイラ GCC 16.2.1、Release -O2 -march=native
測定方法 同一CSVを best of 5 (warmup 1)、ファイルI/O込み
vincentlaucsb/csv-parserの設定 threading(false) 固定、variable_columns(KEEP) で余り列許容
Glazeの設定 glz::read<opts_csv{.layout=colwise}>(ColWise, content)(3列構造体)
データ clean(引用符なし)/ quoted(引用符あり)/ multiline(フィールド内改行)の3種類を混在

速度比較:単スレッドではGlazeが速い

200k行・500k行(3列)

データセット vincent glaze 倍率
clean_200k (4.7MB) 66.7ms 29.1ms 2.29x
quoted_200k (6.6MB) 68.3ms 41.6ms 1.64x
multiline_200k (4.7MB) 66.9ms 26.6ms 2.51x
clean_500k (12MB) 165.9ms 63.3ms 2.62x
quoted_500k (17MB) 171.1ms 127.5ms 1.34x
multiline_500k (12MB) 165.7ms 64.3ms 2.58x

Glazeはクオート付きのフィールドが含まれるCSVは若干苦手なようですが、それでも vincentlaucsb/csv-parser よりも優位に立つことが多いです。

1MB程度の小さなデータ

もうすこし小さなデータでも確認してみます。

データセット vincent glaze 倍率 備考
clean_1MB (43k行) 16.3ms 6.3ms 2.59x
quoted_1MB (30k行) 12.3ms 5.8ms 2.12x
multiline_1MB (43k行) 16.8ms 6.8ms 2.45x
6列CSV(余り列あり) 11-12ms 成功 fail unknown_key — glazeは失敗

やはり単スレッドではGlazeが1.3〜2.6倍速いという結果になりました。 ただし最後の行が重要で、余り列があるとGlazeは失敗してしまうのです。 vincentlaucsb/csv-parserはVariableColumnPolicy::KEEPで余り列を無視することができるのです。

一般論として「vincentlaucsb/csv-parserは最速である」という記述がおおく、コーディングエージェントに尋ねてもこの結果になることが多いのですが、これはthreading(true)による並列処理時の話です。単スレッドrow-iterationでは逆転しています。

スレッド有効化の分岐点は50MB

vincentlaucsb/csv-parser は threading(true) でSPSC + 投機的並列が有効になります。 これを実際に体感するため、1MB〜80MBで計測してみました。

ファイルサイズ clean ON clean OFF 倍率 quoted ON quoted OFF 倍率
1 MB 28.5 ms 17.1 ms 0.60 26.7 ms 12.4 ms 0.47
5 MB 157 ms 87.6 ms 0.56 108 ms 53 ms 0.49
10 MB 310 ms 173 ms 0.56 337 ms 102 ms 0.30
30 MB 1046 ms 374 ms 0.36 764 ms 270 ms 0.35
50 MB 429 ms 744 ms 1.73 1342 ms 530 ms 0.40
80 MB 687 ms 1185 ms 1.72 463 ms** 847 ms 1.83

綺麗に50MBで処理速度が変わりました。

  • 50MB未満 : threading(false)として単一スレッドにした方が速いです。スレッド間のキュー同期がオーバーヘッドになるようです。
  • 50MB以上 : 投機的並列が機能し始め、cleanでは1.73倍、quotedは80MBで1.83倍の高速化が得られます。

機能比較:余り列の扱いが決め手

要件 vincentlaucsb/csv-parser Glaze
単スレッド ○ threading(false) ○
multiline(RFC4180) ○ デフォルト有効 ○ colwiseで可
ヘッダ後付け ○ no_header().column_names(...) △ use_headers=falseで位置依存
余り列を無視(エラーにしない) ○ VariableColumnPolicy::KEEP × unknown_keyで失敗
行数・バイトオフセット取得 ○ n_rows() / byte_offset() × vector.size()のみ

ユースケース別の使い分け

要件4点すべて必要 → vincentlaucsb/csv-parser

#include "csv.hpp"
using namespace csv;

CSVFormat fmt;
fmt.threading(false)
   .no_header()
   .column_names({"id", "value", "name"})          // ヘッダ後付け
   .variable_columns(VariableColumnPolicy::KEEP);   // 余り列を捨てる

CSVReader reader("data.csv", fmt);
for (auto& row : reader) {
  auto id    = row["id"].get<int>();
  auto value = row["value"].get<double>();
  auto name  = row["name"].get<std::string>();
}
size_t total = reader.n_rows(); // 処理済み行数

struct と CSV を 1 対 1 対応させたい → Glaze

列数が構造体フィールド数と一致する場合、Glazeは擬似的なリフレクションにより最もシンプルに書けます。 また単スレッドでは vincentlaucsb/csv-parser より1.3〜2.6倍速いです。

#include "glaze/glaze.hpp"

struct Record {
  int id;
  double value;
  std::string name;
};

std::vector<Record> records;
glz::read<glz::opts_csv{.layout = glz::colwise}>(records, csv_content);

数GBのETL → vincentlaucsb + threading(true)

50MB超ならthreading(true)で投機的並列が有効になる vincentlaucsb/csv-parser が高速になります。 DataFrameやchunk_parallel_applyでETLパイプラインも組めます。

手軽に読み書きしたいだけ → rapidcsv

rapidcsv::Document doc("data.csv");
auto col = doc.GetColumn<double>("value");

APIが最も簡潔です。ただし全行メモリ展開のため5MB超では遅くなります。

まとめ

シナリオ 推奨
余り列あり / ヘッダ後付け / multiline vincentlaucsb/csv-parser
struct ↔ CSV、列数一致、速度優先 Glaze
50MB超のETL vincentlaucsb/csv-parser + threading(true)
小規模、手軽に読み書き rapidcsv
依存ゼロ、シングルヘッダで手軽に導入 fast-cpp / csv2 / lazycsv

速度だけを見るとGlazeが単スレッドで約2倍速いです。 ちょっとしたデータ処理であればGlazeで十分ですが、クレンジングが必要なゴミが多いデータや大規模データのETLにはvincentlaucsb/csv-parserが適しています。

個人的には、JSON/CSV/YAML/TOMLなどのデータ形式ではほぼ最初にGlazeを検討するぐらいGlaze推しなので、納得の行く結果になりました。ref

一方今年に入って開発が再開された vincentlaucsb/csv-parser の強みも明確になったのが収穫でした。 今もマルチスレッド対応や大規模データのETL性能向上など着実に進化しているので、今後も注目していきたいと思います。

枯れたジャンルと思っていましたが、C++のCSVライブラリにはまだ発展の余地があるみたいで楽しめそうです。
リポジトリの最新タグを高速に取得するためにlibgit2を使った話

githubのAPIに頼らずにgitリポジトリの最新タグを取得する必要がでてきて、libgit2を使う方法を色々試した内容をまとめてみました。

やりたかったことは、

複数の git リポジトリの最新タグを並列で取得して新規で追加されたタグの情報を時系列で表示する

というものです。 gitに詳しい方はご存知かもしれませんが「時系列で表示」が今回のポイントです。

単純な「タグ一覧を取ってくる」だけの処理に見えて、実装してみるとlibgit2固有の落とし穴が次々と顔を出したので、最終的に安定して動くようになるまでに色々と試行錯誤しました。

検討した3つの方法

リポジトリのタグ一覧を取得する方法としては以下のような選択肢があります。

方法 通信量 注釈タグのタグ時刻 制限
A. git ls-remote を subprocess で呼ぶ 少 取れない git CLI 必須
B. GitHub REST API の tags endpoint 中 paginate で別途 commit API を叩く必要 githubのみ、API利用制限あり
C. GitHub Graphql API の tags endpoint 少 paginate で別途 commit API を叩く必要 githubのみ、API利用制限あり
D. libgit2 で git_remote_connect + git_remote_ls 少 問題なし libgit2 リンクのみ
E. git cloneしてgit tags で取得 大 問題なし git CLI 必須

「最新タグのリリース時刻を知りたい」という要件だと、方法B.はタグ一覧を取ったあとにコミットのコミッタ日時を別途問い合わせる必要が出てきます。 方法C.でGraphQLを工夫すれば1回の問い合わせですみますん、どちらについてもGitHubに依存してしまいます。 他gitホストでも動くことも考えると、ホスト固有APIに依存したくありません。

方法A.は一番手軽なのですがgit ls-remoteが返すのはref名とOIDの組だけで、annotated tagの「タグ自体が付与された時刻」までは取得できません。 annotated tagはtagオブジェクトとして実体を持っていて、taggerフィールドに時刻が入っています。 lightweight tagならrefが直接コミットを指すのでrefのOIDとcommitの時刻が取得できるのですが、annotated tagの場合はタグオブジェクトをdewreferenceしてtaggerを読む必要でてきます。

これを実現しようとすると、git for-each-ref --format='%(taggerdate)' のようなコマンドも実行する必要がでてきてしまいます。 さすがにこれはかなりの負荷になってしまいますので、なるべく避けたいやり方です。

何も考えずに git clone して git tag で取得する方法E.は、リポジトリの履歴を全部落としてくるので通信量が大きく、数百MBのリポジトリだと数分かかってしまいますし、巨大なリポジトリだと最悪ディスクフルを起こす可能性もあります。これも避けたいところです。

ここでは結果として「D. libgit2でgit_remote_connect + git_remote_ls」を採用しました。 リンク1つで済み、annotated tagのtaggerも git_tag_lookup 1回で取れるためです。

以下ではその具体的な方法を記載します。

ls-remote 相当は libgit2 で書ける

libgit2で git ls-remote と同等の処理をして、annotated tagのtagger時刻(実質タグ付けした時刻)まで取得する関数です。

std::string_view url = ""; // ここにリポジトリのURLを入れる

git_remote* remote = nullptr;
git_remote_create(&remote, repo, "origin", url.data());

git_remote_callbacks callbacks = GIT_REMOTE_CALLBACKS_INIT;
git_remote_connect(remote, GIT_DIRECTION_FETCH, &callbacks, nullptr, nullptr);

const git_remote_head** refs = nullptr;
size_t count = 0;
git_remote_ls(&refs, &count, remote);

refs[i]->name には refs/tags/v1.2.3 のような完全なref名が入ります。 annotated tagの場合は refs/tags/v1.2.3^{} という「deref表記」といわれるrefも含まれます。 両者を同一のタグ名に統合するために ^{} 付き と ^{} 無し から同一タグ名を取り出してマージしています。

// デリファレンスされたタグ(Annotated Tagの実体)
if (ref_name.ends_with("^{}")) {
  auto tag_name = ref_name.substr(10, ref_name.size() - 13);
  if (is_exclude_tag(tag_name)) continue;
  tag_map[std::string{tag_name}].commit_oid = refs[i]->oid;
} else {
  auto tag_name = ref_name.substr(10);
  if (is_exclude_tag(tag_name)) continue;
  auto& tag_info = tag_map[std::string{tag_name}];
  tag_info.ref_oid = refs[i]->oid;
  if (tag_info.commit_oid.id[0] == 0) {
    tag_info.commit_oid = refs[i]->oid;
  }
}

libgit2を使うことで ls-remote 単体でここまで情報を取ることができます。 さらにannotated tagのtagger時刻を取得するには git_tag_lookup でタグオブジェクトを取得し、git_tag_tagger でtaggerの情報を取り出すことができます。 ローカルにcloneを作る必要はなく、リモートのタグオブジェクトを直接取得できるのです。

gitリポジトリからの情報取得という要件については「これで解決!」と思ったのですが、実際に運用してみると色々とハマりどころが出てきました。 以下にそのハマりどころとその回避策をまとめます。

はまりどころ (1): make_latest タグが大量に降ってくる

git ls-remote はタグを全部返してしまうため、膨大なタグがあるリポジトリでは処理が遅くなってしまいます。 一部の巨大リポジトリだと ciflow/20260731.1 みたいなCIタグを毎日自動的に付与しています。 これを1件ずつfetchして日時を取得していると、膨大な時間がかかってしまいます。

この問題を回避するために2つの方法をとりました。

必要のないタグを名称で判断して弾く

以下のような関数でタグ名を判定させて、必要のないタグを弾くようにしました。

bool is_exclude_tag(std::string_view const tag) {
  if (tag.starts_with("latest"))      return true;
  if (tag.starts_with("stable"))     return true;
  if (tag.contains("nightly"))       return true;
  if (tag.contains("Nightly"))       return true;
  if (tag == "dev")                  return true;
  if (tag.starts_with("ciflow/"))    return true;
  if (tag.starts_with("viable/"))    return true;
  if (tag.contains("-alpha"))        return true;
  if (tag.contains("-beta"))         return true;
  if (tag.contains("-rc"))           return true;
  if (tag.contains("-pre"))          return true;
  if (tag.starts_with("snapshot"))   return true;
  if (tag.starts_with("build"))      return true;
  return false;
}

※これは例です。実際の運用ではリポジトリごとに除外ルールを追加する必要があります。

取得件数を制限する

それでも残るタグには MAX_TAGS 上限を設けて、超えた場合は名前順でソートして末尾N件だけ残します。 タグの名前でソートするのは、タグ名はたいてい増分するように付けられるので、名前順で末尾を残すと「最新のタグ」を残すことができるからです。

この方式で余分なタグ名が「最新のタグ」として抽出されてしまう場合には上の is_exclude_tag に定義を追加して弾くようにしています。

適切に除外ルールを用意することでMAX_TAGSは50件程度で十分最新情報が取れるようになります。

constexpr size_t MAX_TAGS = 50;
if (tag_map.size() > MAX_TAGS) {
  std::vector<std::pair<std::string, TagInfo>> sorted(
      std::make_move_iterator(tag_map.begin()),
      std::make_move_iterator(tag_map.end()));
  std::ranges::sort(sorted, std::less<>{}, &std::pair<std::string, TagInfo>::first);
  auto const keep_begin = sorted.begin() + (sorted.size() - MAX_TAGS);
  // 末尾 MAX_TAGS 件だけ残す
}

はまりどころ (2): fetch は shallow で、blob は飛ばす

git ls-remote相当ができるようになったため、ボトルネックとなるディスクIOの過負荷がなくなるため、リポジトリ単位でスレッドを立てて並列でタグ一覧を取得できるようになります。

しかしtaggerの時刻を読むには git_tag_lookup するためにtagオブジェクト本体を手元に持ってくる必要があります。

git_remote_fetchを呼ぶとリポジトリの履歴全部取得してしまいます。 これを複数スレッドで実行するとディスクIOの負荷がとても高くなるためpartial clone + shallow fetchを組み合わせて、必要なタグオブジェクトだけを取得するようにしました。

// blob:none で通信量とディスク IO を最小化
git_config* config = nullptr;
if (git_repository_config(&config, repo) == 0) {
  git_config_set_string(config, "remote.origin.partialclonefilter", "blob:none");
  git_config_free(config);
}

// フィルタ後のタグだけを個別 refspec で fetch
std::vector<std::string> tag_refspecs;
for (auto const& [tag_name, _] : tag_map) {
  tag_refspecs.push_back(std::format("+refs/tags/{}:refs/tags/{}", tag_name, tag_name));
}
git_strarray refs_array = { refspec_ptrs.data(), refspec_ptrs.size() };
git_fetch_options fetch_opts = GIT_FETCH_OPTIONS_INIT;
fetch_opts.depth = 1; // shallow fetch: 一世代だけ取得する
git_remote_fetch(remote, &refs_array, &fetch_opts, nullptr);

blob:none で depth=1 を組み合わせることで、タグオブジェクトと直近コミットのメタデータだけをpullするようになります。 こうすることで1万refのリポジトリでも10秒程度で終わるようになります。

はまりどころ (3): SIGPIPE でスレッドが死ぬ

リポジトリごとのマルチスレッド化して運用し始めると、特定のリポジトリで git_remote_free() がSIGPIPEを投げてスレッドごと停止してしまう場合がありました。

これはlibgit2内部のTLS shutdownがclosed socketにsendしているのが原因でした。

根本解決は難しいのですが、スレッド起動時に一度だけSIGPIPEをブロックすることで回避できることが分かったため、以下のようにアドホックに回避しています。

futures.emplace_back(std::async(std::launch::async, [&] {
  // git_remote_free() 内の TLS shutdown で send() が SIGPIPE を投げるため、
  // スレッド起動時に一度だけブロックする
  sigset_t sigpipe_mask;
  sigemptyset(&sigpipe_mask);
  sigaddset(&sigpipe_mask, SIGPIPE);
  if (pthread_sigmask(SIG_BLOCK, &sigpipe_mask, nullptr) != 0) {
    LOG_WARNING(...);
  }
  // ... 処理 ...

本来はclose直前にマスクすればいいはずなのですが、最適化の影響でSIGPIPEが想定外に早く投げられるケースがあったため、スレッドの冒頭で1回だけブロックするのが一番確実でした。

はまりどころ (4): Windows と libgit2 のターゲット選択

これはlibgit2の問題ではなく、CMakeのターゲット選択の問題なのですが、Windows MSVC向けにビルドしていると、CMake 上のcxx_std_26をVS 2026 generatorが解釈せず、コンパイラフラグrxskが無視されてリンクが壊れる場合がありました。

VS 2022 generatorに戻し、libgit2のターゲット選択もOSベースの切り分けに戻すことで回避することができました。

CMakeLists.txtでcross-platformな抽象化にこだわったのではまった問題でした。 変にこだわらず、 if(WIN32) ... elseif(APPLE) ... else() ... のプラットフォーム分岐を書くのが一番確実でした。

まとめ

何も考えずにタグを取得するだけならばgit ls-remoteで十分なのですが、タグの付与時刻を取得する場合にはannotated tagのtagger時刻を取得する必要があります。

libgit2を使い、partial cloneとshallow fetchで最低限のオブジェクトをローカルに取得するだけでリモートのタグオブジェクトを直接取得できるようになりました。

細かいハマりどころはありましたが、libgit2を使うことでディスク負荷を抑えつつ色々な情報が取れたのはlibgit2を使う大きなメリットだったと思います。

quillで日本語メッセージがが文字化けしてしまう原因と解決方法

はじめに

quill は、低レイテンシ・高スループットを追求した C++ 向け非同期ロギングライブラリです。 個人的にはC++ロギングライブラリの決定版だと思っています。

quillは低レイテンシを実現するためにフロントエンドとバックエンドの2つの部分に分かれています。

  • フロントエンドがいわゆる「ログ出力を呼び出す側」でアプリケーションコードでのquill関数の呼び出し部分に相当します。
  • バックエンドが「実際にログを出力する側」で、別スレッドで動作していて、フロントエンドから渡されたログ出力内容を受け取り、フォーマットしてコンソールやファイルなどに出力します。

フロントエンド(呼び出し元スレッド)での処理を最小化する設計により、spdlog や log4cxx と比較して桁違いのパフォーマンスを誇り、高頻度ログが求められるユースケースで非常に優秀なパフォーマンスを発揮します。

今まで英語でのメッセージばかり書いていて気がついていなかったのですが、日本語メッセージをログ出力しようとすると、コンソールでもファイルでも次のように化けてしまうことに気がつきました。

2024-01-15 10:00:00.000000 [INFO ] ユーザーが\xE3\x83\xAD\xE3\x82\xB0\xE3\x82\xA4\xE3\x83\xB3\xE3\x81\x97\xE3\x81\xBE\xE3\x81\x97\xE3\x81\x9F

std::print や std::fstream では同じ文字列が問題なく出力されるにもかかわらず、quill だけが化けるので、コンソールのエンコーディングの問題ではありません。 この現象はquill の環境設定の問題ではなく、意図された設計上の動作になります。

本記事ではその仕組みと解決策をメモしたものになります。


現象の再現

まず現象を最小コードで確認します。

#include "quill/Backend.h"
#include "quill/Frontend.h"
#include "quill/LogMacros.h"
#include "quill/Logger.h"
#include "quill/sinks/ConsoleSink.h"

int main() {
  quill::Backend::start(); // デフォルト設定で起動

  auto console_sink =
    quill::Frontend::create_or_get_sink<quill::ConsoleSink>("sink_id_1");
  quill::Logger* logger =
    quill::Frontend::create_or_get_logger("root", std::move(console_sink));

  LOG_INFO(logger, "処理を開始します");
  LOG_INFO(logger, "ユーザー名: {}", std::string{"山田太郎"});
  LOG_WARNING(logger, "エラーが発生しました: {}", std::string{"ファイルが見つかりません"});
}

実際の出力:

2026-01-15 10:00:00.000000 [INFO ] \xE5\xBD\xA6\xE7\x90\x86\xE3\x82\x92\xE9\x96\x8B\xE5\xA7\x8B\xE3\x81\x97\xE3\x81\xBE\xE3\x81\x99
2026-01-15 10:00:00.000000 [INFO ] \xE3\x83\xA6\xE3\x83\xBC\xE3\x82\xB6\xE3\x83\xBC\xE5\x90\x8D: \xE5\xB1\xB1\xE7\x94\xB0\xE5\xA4\xAA\xE9\x83\x8E
2026-01-15 10:00:00.000000 [WARNING] \xE3\x82\xA8\xE3\x83\xA9\xE3\x83\xBC\xE3\x81\x8C\xE7\x99\xBA\xE7\x94\x9F...

日本語の文字列がすべて \xNN 形式の16進数エスケープに変換されています。


quill のアーキテクチャを理解する

1. フロントエンド/バックエンド分離モデル

冒頭でも書きましたが、quill の最大の特徴は、ログ処理をフロントエンドとバックエンドの2スレッドに完全分離している点です。

【フロントエンド(呼び出し元スレッド)】
  │  LOG_INFO(logger, "処理開始: {}", msg)
  │    ↓                                  
  │  引数を型情報ごとバイナリシリアライズ 
  │    ↓                                  
  │  ロックフリーキューに enqueue         
  │  ※フォーマット処理は一切行わない      
                     │ ロックフリーキュー
                     ↓
【バックエンド(専用ワーカースレッド)】
  │  キューから dequeue                    
  │    ↓                                   
  │  {fmt} でフォーマット文字列を構築      
  │    ↓                                   
  │  check_printable_char でサニタイズ  ◀── ここで化ける
  │    ↓                                   
  │  各 Sink(Console/File 等)に書き出し  

フロントエンドは引数をシリアライズしてキューに積むだけなので、呼び出し元スレッドへの影響が極めて小さくなります。 これがquillが低レイテンシでアプリケーションに負荷をかけない理由です。

フォーマットや出力処理はすべてバックエンドスレッド内のパイプラインで実施されるのですが、そのパイプラインの中に 文字サニタイズが組み込まれています。

2. check_printable_char の役割

バックエンドがフォーマット済み文字列をシンクに渡す直前、BackendOptions::check_printable_char の設定に従って各バイトを検査します。

デフォルトの判定ロジック(概念的な等価コード):

// quill のデフォルト動作(概念コード)
auto const is_printable = [](char c) -> bool {
  // バージョンにより差はあるが、概ね ASCII 可視文字 + 改行/タブ/CR を許可
  return (c >= ' ' && c <= '~') || c == '\n' || c == '\t' || c == '\r';
};
バイト値 文字例 判定 出力
0x20〜0x7E ASCII 英数字・記号 ✅ 通過 そのまま出力
0x0A/0x09/0x0D 改行/タブ/CR ✅ 通過 そのまま出力
0xE3 日本語 UTF-8 の先頭バイト ❌ 遮断 \xE3 に変換
0x81 日本語 UTF-8 の後続バイト ❌ 遮断 \x81 に変換

日本語の UTF-8 エンコードでは1文字が3バイトで表現されます。

例えば「あ」は 0xE3 0x81 0x82 ですが、3バイトすべてが ASCII 範囲外のためそれぞれエスケープされ、\xE3\x81\x82 という出力になります。

3. この設計の背景

意図的な安全機能として設計されているようです。

ドキュメントやコメントを見るかぎり、以下のような理由があるようです。

  • 制御文字の混入防止:ユーザー入力由来のログに \x00〜\x1F の制御文字が含まれると、ターミナルのエスケープシーケンスとして解釈され、表示が崩れる可能性があるため
  • バイナリデータの可視化:プロトコルパーサーやネットワークデータをダンプする用途では、非 ASCII バイトを hex 表示する方が都合がよい場合があるため
  • ログの輸送・解析の安全性:ログ収集基盤(Fluentd・Elasticsearch 等)によっては非 ASCII バイトの扱いが不定なため、エスケープすることで確実に処理してもらうため

欧米中心の開発者にとっては「非 ASCII = 制御文字かバイナリ」という前提が成り立ちやすい、という国際化でのよくあるパターンですね。

このデフォルト設定は合理的な選択なのですが、日本語環境では意図せず全文字化けするという問題を引き起こしてしまいます。


解決策

実は解決方法はとても単純です。

BackendOptions::check_printable_char に空の値({})を設定してサニタイズを無効化するだけです。

#include "quill/Backend.h"
#include "quill/Frontend.h"
#include "quill/LogMacros.h"
#include "quill/Logger.h"
#include "quill/sinks/ConsoleSink.h"

int main() {
  quill::BackendOptions backend_options;
  backend_options.check_printable_char = {}; // サニタイズを無効化
  quill::Backend::start(backend_options); // ← BackendOptions を渡して起動

  auto console_sink =
    quill::Frontend::create_or_get_sink<quill::ConsoleSink>("sink_id_1");
  quill::Logger* logger =
    quill::Frontend::create_or_get_logger("root", std::move(console_sink));

  LOG_INFO(logger, "処理を開始します");
  LOG_INFO(logger, "ユーザー名: {}", std::string{"山田太郎"});
  LOG_WARNING(logger, "エラーが発生しました: {}", std::string{"ファイルが見つかりません"});
}

修正後の出力:

2026-01-15 10:00:00.000000 [INFO ] 処理を開始します
2026-01-15 10:00:00.000000 [INFO ] ユーザー名: 山田太郎
2026-01-15 10:00:00.000000 [WARNING] エラーが発生しました: ファイルが見つかりません

Backend::start() に BackendOptions を渡すのがポイントです。 オプション変更後に Backend::start() を引数なしで呼ぶと、デフォルト設定になってしまうので意味がありません。


カスタムフィルタで日本語だけサニタイズから除外する

サニタイズを完全にオフにしたくないが、日本語は通したい

という場合もあると思います。

そういう場合には、カスタムの判定ロジックを指定することもできます。

実は check_printable_char は文字許可判定コールバックで、true を返したバイトはそのまま通過、false を返したバイトは \xNN にエスケープされます。

quill::BackendOptions backend_options;

// ASCII 印字可能文字 + 改行 + UTF-8 マルチバイトバイト(0x80〜)を通過させる
backend_options.check_printable_char = [](char c) -> bool {
  auto const uc = static_cast<unsigned char>(c);
  // ASCII 印字可能範囲(0x20〜0x7E)と改行
  if ((uc >= 0x20 && uc <= 0x7E) || uc == '\n') {
    return true;
  }
  // UTF-8 マルチバイトシーケンス(先頭バイト: 0xC0〜0xFF、後続バイト: 0x80〜0xBF)
  if (uc >= 0x80) {
    return true;
  }
  // 0x00〜0x1F の制御文字はエスケープ(タブ・CR 等も必要なら個別に追加)
  return false;
};

quill::Backend::start(backend_options);

この設定により:

入力 動作
"日本語テスト" (UTF-8 日本語) ✅ そのまま出力
"Hello" (ASCII) ✅ そのまま出力
"\x01\x02" (制御文字) ❌ \x01\x02 にエスケープ
"\t" (タブ) ❌ \x09 にエスケープ(必要なら uc == '\t' を条件に追加)

ユーザー入力をそのままログに含める場合は、制御文字のエスケープを維持しつつ日本語のみ通過させるこの設定の方が安全だと思います。


まとめ

quillで日本語メッセージが化けてしまうのは、バックエンドスレッドの check_printable_char がデフォルトで ASCII 印字可能範囲外のバイトをエスケープしてしまうためでした。

これはquillの意図されたデフォルト設定なため、backend_options.check_printable_char = {} を Backend::start() 前に設定することで、サニタイズを無効化して日本語ログを正しく出力できるようになります。

quillは今までの高速なロギングライブラリであるとともに、アプリケーションロジックの実行に影響を与えないバックエンドでの様々な処理を実現するための設計がされています。

今回は日本語ユーザーには不便なデフォルト設定でしたが、それ以外にも様々なカスタマイズが可能になっていますので、公式ドキュメントを参照してみてください。

std::formatの第1引数を文字列リテラル以外にできない理由と回避策

C++20で導入された std::format(C++26では std::print も追加されました)が使えるようになって、C++もだいぶモダンな書き方ができるようになってきました。 何よりiomanipで状態管理をする必要がないのはストレスがなくてよいですね。 第1引数のフォーマット文字列のパースがコンパイル時に行われるので、実行時の効率が良いのもC++らしくて好きです。

積極的に使っていた std::format ですが、C++23, C++26で緩和されたconstexprの機能を利用して、 自作の consteval 関数や std::array でコンパイル時に生成したフォーマット文字列を渡そうとすると、途端にコンパイルエラーになってしまうことに気がつきました。

例えば、以下のようなコードは一見動きそうですが、コンパイルエラーになります。

#include <array>
#include <format>
#include <string_view>

// すごく簡単なFixedString
template <std::size_t N>
struct FixedString {
  std::array<char, N> data{};
  consteval FixedString(std::array<char, N> const& arr) noexcept {
    for (auto i = 0u; i < N; ++i) {
      data[i] = arr[i];
    }
  }
  consteval std::string_view sv() const noexcept {
    return std::string_view{data.data(), N - 1};
  }
};

consteval auto generate_format() noexcept {
  // 本来はconstevalな処理でgenerated_strを作成しています。
  auto generated_str = std::array<char, 9>{"hello {}"};
  return FixedString<generated_str.size()>(generated_str);
}

int main() {
  constexpr auto g = generate_format();
  //  error: call to consteval function 'std::basic_format_string<char, int>(g.FixedString<9>::sv())' is not a constant expression
  auto str = std::format(g.sv(), 50);
}

wandbox

prog.cc: In function 'int main()':
prog.cc:29:30: error: call to consteval function 'std::basic_format_string<char, int>(g.FixedString<9>::sv())' is not a constant expression
   29 |   auto str = std::format(g.sv(), 50);
      |                          ~~~~^~
prog.cc:29:36: error: 'std::format_string<int>{std::basic_string_view<char>{8, ((const char*)(& g.FixedString<9>::data.std::array<char, 9>::_M_elems))}}' is not a constant expression
   29 |   auto str = std::format(g.sv(), 50);
      |                                    ^
prog.cc:29:36: error: 'std::basic_format_string<char, int>(g.FixedString<9>::sv())' is not a constant expression because it refers to an incompletely initialized variable
  • 「なぜ文字列リテラルなら通るのに、constexpr な std::string_view だとダメなのか?」
  • 「どうすれば consteval で作った文字列から std::format_string を作れるのか?」

という疑問がでてきたのでちょっと調べてみました。

この問題の原因と、その裏にあるC++のテンプレート型推論を駆使した std::format の仕組みについて、私なりにまとめておきます。

結論: constevalで生成した文字列をstaticにする

std::format の第1引数は std::format_string という特殊な型になっています。

この std::format_string のコンストラクタは consteval で定義されているため、引数で渡される文字列はコンパイル時に評価可能であることが必要になります。

この制約はコンパイル時にその中身({} の数や型)を検証できるようにするためです。

通常の constexpr 変数や一時オブジェクトでは、ポインタのライフタイムや評価文脈の都合で、コンパイルエラーになることがあります。

このため、main関数内の g 変数の定義を次のようにstaticを追加してライフタイムを拡大すると、今回のようなエラーを回避できるケースが多いです。

  // 前
  constexpr auto g = generate_format();
  // 後
  static constexpr auto g = generate_format();

wandbox

同じconstevalなので混乱してしまうのですが、「前」の方では generate_format() の戻り値がスタック上に生成される(文字列データの計算はコンパイル時に実施)のに対して、「後」の方では静的記憶域に生成されるのが大きな違いになります。

std::formatの第1引数の型であるstd::format_stringは、コンストラクタをconstevalにしているため、実質的には 「コンパイル時に固定的に扱える文字列データ」 が求められます。

このconsteval制約のため、staticではない変数を渡した場合は、処理系によっては「内容は固定でもアドレスの扱いが不十分」と診断され、コンパイルエラーになることがあります。

同じconstevalだけれど、ややこしいですね。C++難しい。

staticを使う以外の回避策が欲しい

「フォーマット文字列をstatic変数として定義する」ので良いのであればこれで話は終わりなのですが、できれば次のようにしたいところ。

auto str = std::format(generate_format().sv(), 50);

これならば、元のstd::formatと同じように書けてすっきりします。 static変数の名前を考えなくてよいのもありがたい。

しかし残念ながら、これは失敗します。

generate_format() の戻り値は一時オブジェクトであり、一時オブジェクトの寿命に依存してしまいます。

当然ながらstaticでないため、std::format_string の consteval コンストラクタが要求する条件を満たせず、コンパイルエラーになります。

この問題を解決するには「文字列データを非型テンプレート引数(NTTP)として型レベルにしてしまうラッパー」 を挟んで処理する方法があります。

とはいえ、正直なところ以下の内容は対処方法が複雑ですし、ラッパー関数の定義が必要などいまいちな部分が多いです。

static定数を定義するのが問題ないのであれば、staticを使う方法で十分だと思います。

「面倒なことはしたくない」のであれば、staticにすればいいと思うので、この先は興味がある方だけ読んでみてください。

NTTPで型レベルにして解決する実装例

#include <array>
#include <format>
#include <print>
#include <string_view>

// テスト用のconsteval文字列生成関数
consteval auto generate_format() noexcept {
  return std::array<char, 9>{"hello {}"};
}

// 1. コンパイル時固定文字列を保持する構造体 (NTTP用)
template <std::size_t N>
struct FixedString {
  std::array<char, N> data{};

  consteval FixedString(std::array<char, N> const& arr) noexcept {
    for (auto i = 0u; i < N; ++i) {
      data[i] = arr[i];
    }
  }

  // std::format_stringが要求する std::string_view への暗黙変換
  consteval operator std::string_view() const noexcept {
    return std::string_view{data.data(), N - 1}; // 末尾のヌル文字を除く
  }
};

// 2. NTTPを介して安全に format_string を生成するラッパー関数
template <FixedString Str, typename... Args>
consteval auto make_format_string() noexcept {
  return std::format_string<Args...>{Str};
}

int main() {
  auto str = std::format(
    make_format_string<FixedString{generate_format()}, int>(), // ここがフォーマット指定文字列
    50
  );
}

wandbox

途端に面倒なコードになってしまいましたが、これで consteval で生成した文字列を std::format_string に安全に渡すことができます。

main関数内の make_format_string のテンプレート引数に FixedString を渡していることがポイントです。

FixedString をmake_format_string関数の型引数(Str)として渡すことで、その文字列データは一時オブジェクトではなく、型レベルの定数として扱える形になります。

この Str から std::format_string<Args...> を構築することで、ポインタ寿命に起因する問題を避けつつ、コンパイル時バリデーションを行いやすくなります。

これだけで終わればいいのですが、面倒なのはmake_format_stringの定義にある Args... の部分です。

呼び出す側では次のように int を渡していますね。

make_format_string<FixedString{generate_format()}, int>

これは何かというと「フォーマット文字列内の {} に対応する引数の型」を指定している部分になります。

今回の場合は 50 という int 型の引数を渡しているので、int を指定しています。

面倒に感じるのですが、std::format_string の設計上、どうしても必要な部分になります。

いつも簡単に呼び出せている std::format を考えると、これは不自然に感じるはずです。

なぜ std::format は手動での型指定がいらないのか?

普段私たちが書いている std::format のコードを思い出してみます。

std::format("hello {}", 50); // なぜこれで通る?

std::format_string は、本来 std::format_string<int> のように、フォーマットする相手の型をテンプレート引数に取る必要があります。

それなのに、なぜ std::format を呼び出すときはリテラルを渡すだけで、後ろの引数の型(int)を自動で認識してくれるのでしょうか?

これには、C++のテンプレート型推論にある Non-deduced context という仕組みが大きく関わっています。

1. std::format の定義

標準ライブラリにおける std::format のシグネチャは、今回注目している部分だけに絞って書くとだいたい以下のようになっています。

template <typename... Args>
auto format(std::format_string<Args...> fmt, Args&&... args) -> std::string;

第1引数の std::format_string<Args...> と、第2引数以降の Args&&... で、まったく同じテンプレートパラメータパック Args... を示しています。

2. コンパイラは第2引数以降で先に型推論している

C++のルールでは「別のテンプレートクラスの引数にネストされているテンプレートパラメータは、関数の実引数からは推論してはならない」という大原則があります。

Non-deduced context と呼ばれるルールになります。

今回の場合「別のテンプレートクラスの引数にネストされているテンプレートパラメータ」とは、第1引数の std::format_string<Args...> の中の Args... のことを指します。

つまり、コンパイラは第1引数の "hello {}" を見た瞬間、そこから Args... を導き出すことをスキップします。

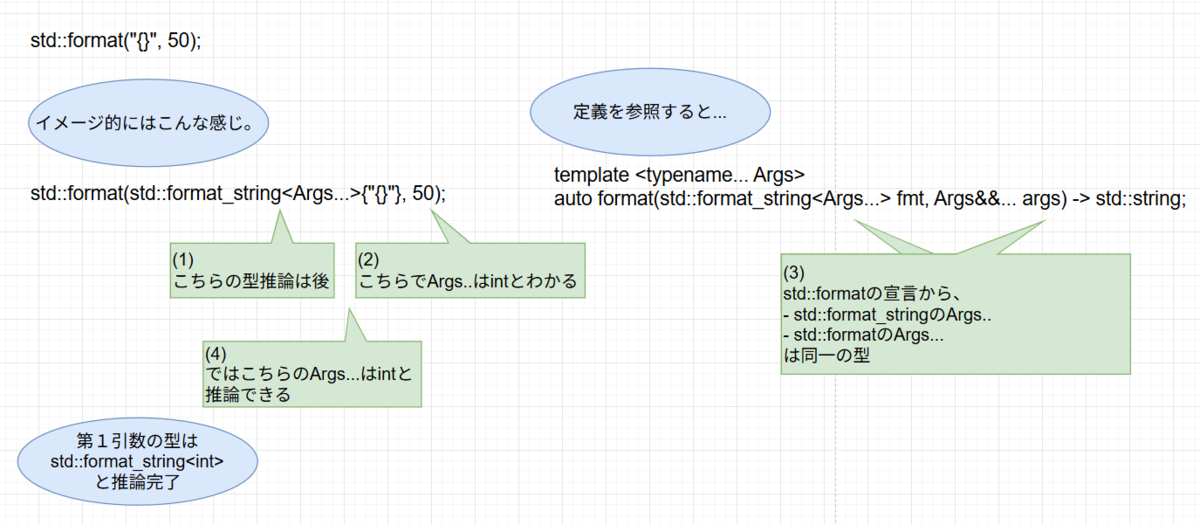
その結果、コンパイラは以下のように型推論を実施します。

  1. 第1引数は無視して、第2引数の 50 を見る。
  2. 50 は int 型なので、Args... の中身を {int} と確定させる(こちらは簡単に推論可能)。
  3. 確定した int を第1引数に遡って適用させ、第1引数の要求する型を std::format_string<int> と決定する。
  4. 型が決まった後、渡されたリテラル "hello {}" を std::format_string<int> の consteval コンストラクタを呼び出す。
  5. コンストラクタでは中身をパースして {} の部分をバリデーションして、問題なければ std::format_string<int> のオブジェクトを生成する。

型推論の逆流のイメージ

このように「後ろの引数から型を決定して前に逆流させる」というトリックがあるおかげで、型指定なしで std::format を呼び出せるのです。

フォーマット指定文字列だけで、型は指定したくない場合は?

std::format は「文字列リテラルを直接その場に書くユースケース」に想定した設計になっているため、フォーマット指定文字列から型を推論するための逆流システムが組み込まれています。

そのため、今回のように「別の場所で consteval 生成した std::array を流し込む」というコードを書こうとすると、この逆流システムと std::format_string の consteval 要件が噛み合わず、コンパイルエラーになるケースがあります。

とはいえ、フォーマット指定文字列に対応する型を毎回考えるのは面倒なので、何かしらの回避策が欲しいところです。

あまり綺麗な方法ではありませんが、std::format 関数をラップして Non-deduced context を FixedString の方に移す方法があります。

template <typename T>
constexpr auto normalize_format_arg(T&& value) noexcept -> std::decay_t<T> {
  return static_cast<std::decay_t<T>>(std::forward<T>(value));
}

template <FixedString Str, typename... Args>
auto myformat(Args&&... args) {
  constexpr auto fmt = make_format_string<Str, std::decay_t<Args>...>();
  return std::format(fmt, normalize_format_arg(std::forward<Args>(args))...);
}

wandbox

自前の myformat 関数を呼び出すことになってしまいますが、std::formatのように「フォーマット指定文字列だけで型を指定しない」スタイルで呼び出せるようになります。

auto str = myformat<FixedString{generate_format()}>(50);

シンプルにはなりましたが、ラッピングしているのが格好悪い。

これならば、staticな定数を定義して std::format を呼び出す方がまだマシな気がします。

std::formatが「フォーマット指定文字列をリテラルで書きつつ、引数の数や型を自動で推論してくれる」という便利な機能を提供するために、かなり複雑なトリックを使っていることがわかりますね。

まとめ

  • std::formatの第1引数は、std::format_stringという特殊な型で、constevalなコンストラクタを持つため、完全に固定された文字列データが必要。
  • constevalで生成した文字列をstd::formatに渡すには、static constexpr変数として定義するのが最も簡単な方法。
  • どうしてもstaticを使いたくない場合は、NTTPを使って型レベルにしてからstd::format_stringを生成する方法もあるが、フォーマット内の引数を手動で指定する必要が出てくる。

補足

コンパイル時バリデーションを諦めて、完全に動的な std::string_view からフォーマットしたい場合は、C++26から導入された std::runtime_format を使うのが一番手軽です。

// C++26の動的エスケープハッチ
auto str = std::format(std::runtime_format(g_str), 50);

C++23以前であれば std::vformat を使う方法もあります。

// C++20, C++23の動的エスケープハッチ
auto str = std::vformat(g_str, std::make_format_args(50));

CTREが特定パターンで極端に遅くなるのはgcc15依存の可能性が高そう

先月のブログ記事でとりあげた「特定の正規表現パターンでCTREが極端に遅くなる」という問題ですが、どうやらgcc15のconstexprの最適化が原因のようです。 Fedora Linux 44で梱包されているgcc16.1ではこの問題は発生しないことが確認できたことで、gcc15の特有の問題である可能性が出てきたので追試記事になります。

gcc15特有の問題であるかどうかを確定するためには、他のgccのバージョンも試してみました。 その結果、gcc15だけCTREの動作が100倍近く遅くなっていて、std::regexの2倍以上の時間がかかっていることが分かりました。

gcc バージョン std::regex CTRE CTREの高速化
12.3.1 4356700.259 136445.124 31.93
13.3.1 4578723.324 130958.757 34.96
14.3.1 5211490.627 119742.519 43.52
15.2.1 5236475.337 10953884.903 0.48
16.1.1 7442709.239 117486.034 63.35

※「std::regex」, 「CTRE」の単位はマイクロ秒で、「CTREの高速化」は std::regexの時間 / CTREの時間 で計算しています。

※ 今回は簡単のため、std::regexとCTREの2つだけの比較にしています。

ソースコードは https://github.com/toge/blog-2026-05-20 に置いてあります。

なお、本検証は「gcc15で再現し、gcc16.1で再現しない」ことを示すもので、根本原因を完全に特定したものではありません。 ただし、同一コード・同一CTRE版でコンパイラバージョンだけを跨いだ比較結果として、gcc15依存の可能性は高いと判断しています。

結論

  • gcc12, gcc13, gcc14, gcc15, gcc16と調べてみまたところ、問題なのはgcc15のconstexprの評価である可能性が高いです
  • 基本的にはCTREはstd::regexに比べて数十倍の性能を発揮する非常に強力なライブラリです
  • 正規表現とコンパイラによってはCTREが極端に遅くなる可能性があるため、CTREを利用する際にはベンチマークを取るなどして性能を確認することが重要です

確認したこと

コンパイル環境

Fedora Linux44上でdistroboxを利用してgcc12, gcc13, gcc14, gcc15, gcc16を利用できるようにしました。 distrobox便利ですね。 すごく簡単に複数のgccのバージョンをインストールできてホスト側のFedora Linux44で動作するCMakeやvcpkgで利用することもできました。

詳しいインストール方法はこの記事の趣旨とは外れるので環境構築の方法に記載しておきました。 そちらを参照してください。

gcc15のビルドオプションでの差

gcc15については過剰な最適化が入っている可能性があるため、gcc15のビルドオプションを変えてみましたが、どのオプションをつけてもCTREが極端に遅くなる問題は解消されませんでした。

gcc オプション std::regex CTRE CTREの高速化
-O3 5236475.337 10953884.903 0.48
-O2 5525359.722 11105484.540 0.50
-O1 5186879.916 10983906.584 0.47
-O0 5117050.278 10219686.519 0.50
-Os 5079462.916 9743204.839 0.52

むしろ-Osの方が性能上がるのは、バイナリサイズ縮小によるキャッシュ効率の向上が効いているのかもしれませんね。

簡単な正規表現パターンでの比較

遅くなる要素である*?が2つしか入っていない比較的簡単な正規表現パターンで比較してみました。 これならばCTREはstd::regexに比べて数十倍の性能を発揮していて、gcc15でも問題なく高速であることがわかります。

gcc バージョン std::regex CTRE CTREでの高速化
12.3.1 3281589.653 94315.436 34.79
13.3.1 3345403.169 100617.036 33.25
14.3.1 3577678.070 94330.536 37.93
15.2.1 3520911.834 145153.594 24.26
16.1.1 5578157.750 92408.106 60.36

確認条件

CTREのバージョン

現時点での最新版であるCTRE 3.11.0を全ての環境でビルドして、同じコードで性能を比較しました

使用した正規表現

  • 前回のブログ記事で詳細は記載しているのでそちらを参照してください
  • *?が複数回入っているパターンで、正規表現エンジンでバックトラックが発生しやすいパターンを利用しています

個人的な感想

  • CTREの雪辱をはらすことができたので良かったです
  • それでもPCRE2 JITの方が速いため速さを求めるならばPCRE2 JITですね
  • ベンチマークの重要性を改めて感じる話になりました
  • パターンによってはエンジン実装差が性能に強く出ることがわかりました

高速なはずのCTREがstd::regexより極端に遅くなる場合がある

CTRE(Compile Time Regular Expressions)の紹介

一般にC++の標準ライブラリで提供されているstd::regexは正規表現エンジンの中では比較的遅いとされています。 私が正規表現を高速に処理したい場合に考慮するライブラリの1つがCTRE(Compile Time Regular Expressions v3)です。 Hana Dusíková 氏によって開発されたこのライブラリは、従来のエンジンとはだいぶ異なるアプローチを取っています。

  • コンパイル時解析: std::regexを含め他ライブラリが実行時にパターンの解析を行うのに対し、CTRE はコンパイル時にすべてを終わらせます。
  • ネイティブコード生成: C++ のテンプレートメタプログラミングを駆使し、正規表現専用の判定ロジックを直接アセンブリレベルで生成します。
  • 型安全: 名前付きキャプチャグループなどを構造化束縛で取り出せるため、コードの安全性と可読性が向上します。

1つの正規表現のパターンが数回しか使われない場合、正規表現のパースをコンパイル時に行えるCTREはとても有利になります。 そもそもの正規表現のマッチングにおいてもCTREはstd::regexより高速なことが多いです。

ヘッダオンリーで導入しやすく、最近のC++の流行りを踏まえたシンプルな書き方ができるのも魅力です。

struct date { std::string_view year; std::string_view month; std::string_view day; };

std::optional<date> extract_date(std::string_view s) noexcept {
  if (auto [whole, year, month, day] = ctre::match<"^(\\d{4})/(\\d{1,2}+)/(\\d{1,2}+)$">(s); whole) {
    return date{year, month, day};
  } else {
    return std::nullopt;
  }
}

しかし、特定の書き方によって std::regex より極端に遅くなる ことがあります。 今回まさにこれに遭遇してしまったので、将来の自分のためにも、なぜそうなるのかをまとめておきます。

ことの発端

HTMLスクレイピングのために、本来ならlexborのようなHTMLパーサーを使うべきなのですが、高速性と手軽さを優先して正規表現での情報抽出をしていました。

<li class="item-card[\s\S]*?data-product-id="([0-9]+)"[\s\S]*?data-product-price="([0-9]+)"[\s\S]*?<div class="item-card__title"><a[\s\S]*?href="(https://xxx\.yy/ja/items/[0-9]+)">([\s\S]*?)</a>[\s\S]*?<div class="item-card__shop-name">

「よくもこんな複雑な正規表現を…」と思われるかもしれませんが、対象サイトのHTML構造がほぼ固定されているため、これで十分に目的を達成できていました。

生成AIにひとまずstd::regexで実装してもらい問題なく動いていたのですが、CTREに置き換えたところstd::regexよりも2倍近く遅くなってしまいました。 大抵の場合std::regexから書き換えることで10倍以上の高速化が見込めるので、大きく予想から外れる結果となってしまいました。

※ この方法は対象サイトのHTML構造がほぼ固定されている場合でのみ有効です。一般的なサイトを正規表現だけで厳密に扱う方法ではありません。ちゃんとやるならばHTMLパーサーを使用することを強くオススメします。

どこで遅くなったのか?

CTREが極端に遅くなる原因はバックトラッキングの多発でした。

まさに先程あげたような「最短一致のワイルドカード」を多用するとこの罠にはまります。

<li class="item-card[\s\S]*?data-product-id="([0-9]+)"

正規表現に詳しい方には冗長でしょうが、[\s\S]*? は「空白文字も非空白文字も含む任意の文字列」を表すため、タグ内のどこに data-product-id 属性があってもマッチするための書き方です。 これを [\s\S]* にしてしまうと data-product-id が登場してもマッチが終了せず、タグの終端まで突き進んでしまうため、最短一致の*?を使っています。

なぜ遅くなるのか?

CTREでは正規表現がテンプレートを通じて専用のマッチングコードとして展開されます。 そのため、[\s\S]*? のような境界のない最短一致を含むパターンでは、対象文字列の各位置で「ここから data-product-id が続くか?」を何度も試すことになり、入力や属性位置によってはバックトラッキングが多発します。 その結果、入力や属性位置によっては大きく遅くなり、実測で std::regex より不利になることがあります。

どうすれば遅くならないのか?

これを防ぐには何個か方法があります。

  1. [^>]*?(タグの終端 > 以外の文字)のように「探索の終端」を明示する方法です。こうすることで探索が打ち切られるため、バックトラッキングの爆発を防げます。
  2. もう少し条件を絞って*?の多用を避ける。最短一致のワイルドカードを多用すると極端に遅くなるのでなるべく使わないように工夫する方法です。
  3. あらかじめタグの終端を検索しておき、検索の範囲を狭める。例えばStringzillaのようなSIMD加速の文字列検索ライブラリを置いてタグの終端の位置を特定してから、正規表現で精密に抜き取るという2段階のアプローチです。

とはいえ、CTREでの最短一致の検索は、「正規表現の書き方次第で、極端に遅くなる可能性がある」 ことが潜在的なリスクとして存在してしまいます。 このことを失念して、安易にCTREに置き換えてしまったのを反省しています…。

他のライブラリを使う

とはいえ、正規表現のパターンによる処理時間の爆発に怯えながらCTREを使うのは辛いので、他の強力な正規表現ライブラリを検討するのも一つの手です。

1. PCRE2 : フル機能 + JIT

PCRE2はCTREの同等以上の正規表現の機能を提供しているライブラリです。 さらにJITコンパイル機能を備えているため、実行時に正規表現をマシンコードに変換することができます。 std::regexと比べればJITなしでも十分速いのですが、JITを利用すると異次元の高速化を期待できます。

  • メリット: JITが有効な環境では実行時コンパイルによって高い性能を期待できる。再帰や複雑な後読みなどの複雑な機能も利用可能。
  • デメリット: 実行時にマシン語を生成するためセキュリティポリシーによっては制約を受ける場合がある。

2. RE2 : 絶対に止まらない安全性

Googleが開発したRE2は、CTREとは対照的にバックトラッキングを避けて線形時間保証を優先するNFA/DFA系の正規表現ライブラリです。 今回の用途とは異なりますが、悪意のある正規表現によって正規表現の処理がフリーズすしないように工夫されているため、ユーザーが入力した任意の正規表現を処理するようなシステムでは非常に有用です。

  • メリット: 計算量が入力サイズに対して $O(n)$ であることが保証されており、どれほど複雑な(あるいは壊れた)正規表現を投げても、フリーズすることがない。
  • デメリット: 安全性と引き換えに、先読み・後読み(look-around)やバックリファレンスといった高度な機能が制限されている。

正規表現エンジンの比較まとめ

ライブラリ 導入 実行速度 特徴 弱点
std::regex 標準ライブラリ 遅い 標準で利用可能、広範な機能 パフォーマンスが全体的に悪い
CTRE ヘッダーのみ 高速 コンパイル時最適化、型安全 テンプレート展開によるビルド時間の増大、バックトラックに弱い
PCRE2 リンクが必要 非常に高速 広範囲の正規表現、JITで更に高速化 フリーズ懸念、バックトラッキングのリスク
RE2 リンクが必要 高速 $O(n)$ の速度保証、絶対にフリーズしない 後読みなどの高度な文法が使えない

どう使い分けるべきか?

現代の C++ において、パフォーマンスを最大化するための指針は以下の通りです。

  1. 特定のサイト構造を抜くツール: パターンが決まっており複雑でないならCTRE。ただし、必ず否定文字クラス([^>]*)などで探索範囲を限定し、バックトラックを封じ込めること。
  2. 不特定多数のユーザーが正規表現を入力するシステム: 安全第一の RE2 が定石。
  3. 複雑な再帰構造や後読みを、実行時の柔軟性を保ちつつパースしたい: PCRE2 (JIT) が適している。

さらに速度を追求するなら、これらエンジンの前段に Stringzilla のような SIMD 加速検索を置き、「SIMD でブロックを特定し、正規表現で精密に抜く」 という構成にするとより高速化が期待できますが、実装の複雑さも増すため、用途に応じて検討する必要がありますね。

とはいえCTREは十分速い

結構CTREに厳しい事を書いてしまいましたが、今回はかなり極端なパターンでの話であって、CTREは通常の正規表現のパターンであれば十分に高速です

実際、今回のパターンの複雑さを少しずつ減らしていく([\s\S]*?の数を減らすために後ろから削っていく)と、劇的に高速化していきました。 ある程度パターンが単純ならばPCRE2のJITに肉薄する性能を発揮することもあります。

実際にコードで計測してみましたので、そちらを見てもらえるとわかりやすいと思います。

github.com

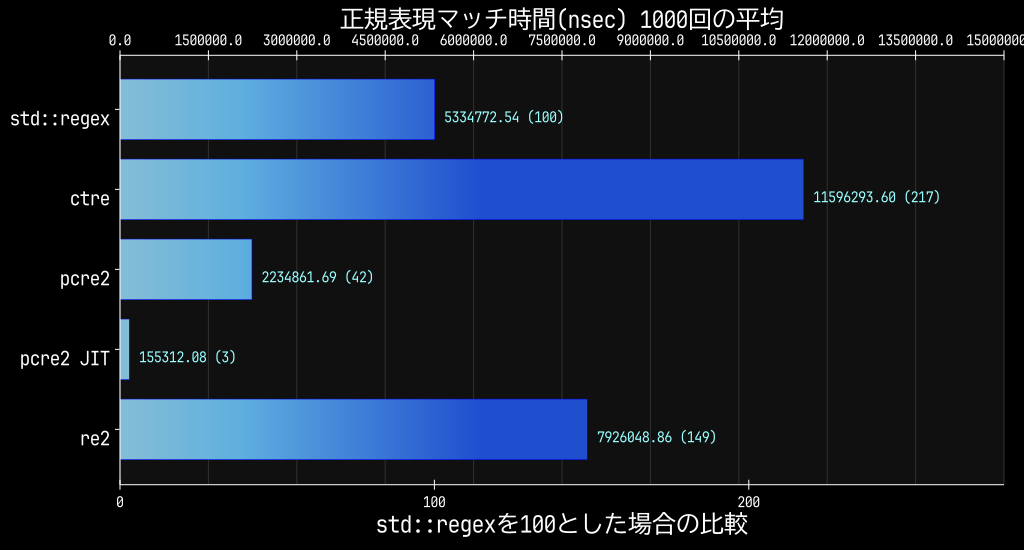
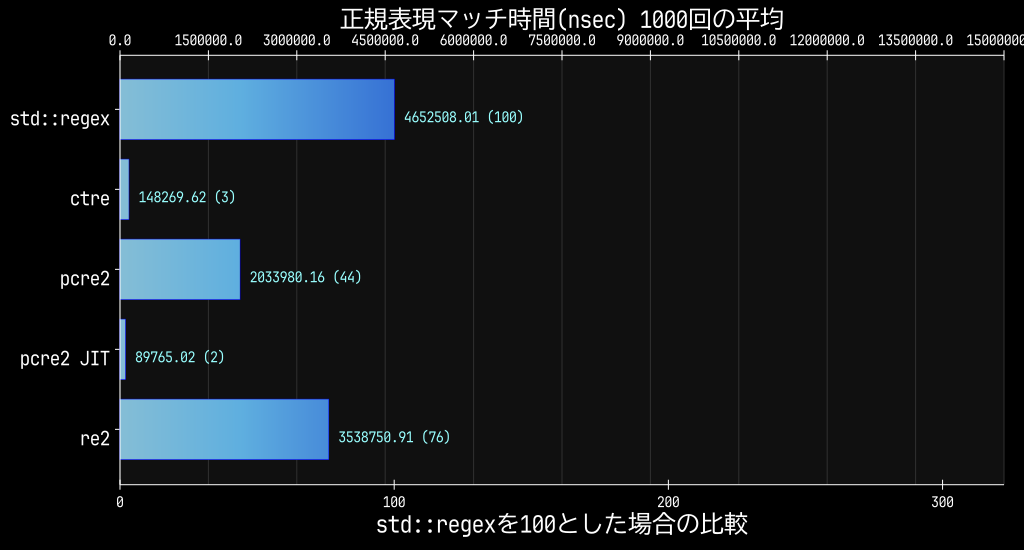
抜粋すると今回のような複雑なパターンでの実行時間は以下のようになりました。 「最短一致のワイルドカード」が6回も入っているため、バックトラッキングに弱いCTREやRE2が極端に遅くなっています。

後ろの方を削って「最短一致のワイルドカード」を3回まで減らすと、CTREはPCRE2のJITに肉薄する性能を発揮しています。

毎回JITコンパイルしているにも関わらず全体的にPCRE2 JITが最強ですね!

ですがC言語のライブラリであるためコードが冗長になりがちですし、C++で甘やかされた身にはメモリ管理が面倒くさい。

  auto ec = 0;
  auto erroroffset = PCRE2_SIZE{};
  auto const re = std::unique_ptr<pcre2_code, decltype([](auto p) {
    pcre2_code_free(p);
  })>{
    pcre2_compile(reinterpret_cast<PCRE2_SPTR>(PATTERN), PCRE2_ZERO_TERMINATED, 0, &ec, &erroroffset, nullptr)
  };

  auto const match_data = std::unique_ptr<pcre2_match_data, decltype([](auto p) {
    pcre2_match_data_free(p);
  })>{pcre2_match_data_create_from_pattern(re.get(), nullptr)};

  auto start_offset = PCRE2_SIZE{0};
  auto const subject = reinterpret_cast<PCRE2_SPTR>(data.data());
  auto const subject_length = data.size();

  while (true) {
    auto const rc = pcre2_match(re.get(), subject, subject_length, start_offset, 0, match_data.get(), nullptr);

    auto const ovector = pcre2_get_ovector_pointer(match_data.get());

単純なパターンで十分に高速で、かつシンプルに書けてしまうCTREが個人的になかなか手放せないのです。

まとめ

正規表現ライブラリは複数ありますが、それぞれが異なる設計哲学とトレードオフを持っているため、「どんな場合でもこれが最強」というものはありません。 特性の把握と、利用する正規表現パターンの性質を理解した上で、適切な選択をする必要があると再認識しました。

vcpkgのwxWidgetsが日本語対応していないので独自レジストリでカスタマイズportを提供する

はじめに

C++でコーディングするのが大好きな私にとって、vcpkgは非常に便利なツールです。 vcpkgだと最新のライブラリを簡単にインストールできるし、プロジェクトごとの依存関係を簡単に管理できるのがとても便利です。

しかし、vcpkgの公式レジストリにはある一定のポリシーがあるため、ちょっと不便なことがあるのです。

  • 自分のプロジェクトに必要なライブラリのportがない
  • 公式レジストリのportに必要な機能がない
  • 何かしらの理由で公式レジストリのportが最新版でない

とはいえ、vcpkgの公式レジストリの恩恵は受けたい。 新しいライブラリが追加されるし、最新版への更新も頻繁に行われるからです。

今回はまさにこの「不便なこと」に陥りました。 そこでこの記事では、vcpkgの独自レジストリを用意して公式レジストリと併用する方法をwxWidgetsを例にして紹介します。

結論を最初に書いておくと、

  • とりあえず手元のプロジェクトだけで試したいならoverlay-ports
  • 複数マシンやCIでも安定して使いたいなら独自レジストリ

という使い分けがわかりやすいです。 今回は環境を跨いで利用しやすい、後者の「独自レジストリ」の手順を中心に説明します。

この記事でわかることは次の通りです。

  • 独自レジストリに必要な最低限のディレクトリ構成
  • 公式portをコピーして独自版に差し替える手順
  • vcpkg-configuration.jsonで公式レジストリと独自レジストリを併用する方法
  • overlay-portsと独自レジストリの使い分け

この用途については公式ドキュメントに詳しい手順があるのですが、より具体的な例を交えて記録しておきます。

きっかけ

vcpkgの公式レジストリで提供されているwxWidgetsを利用しようとしたところ、日本語対応していないことがわかりました。 あらゆる日本語が全部文字化けしてしまいます。

これは2つの理由によるものです。

wxUSE_UNICODE_UTF8を有効にするPRを公式レジストリに提出してみましたが、残念ながら公式レジストリのポリシーによりマージされませんでした。

こんな時にはvcpkgの独自レジストリを自前で用意して公式portの独自版を公式レジストリと併用するのが便利です。

事前準備

当然ではありますが、vcpkgをインストールしてvcpkgをPATHに通しておいてください。

ターミナルで次のように出力されれば準備OKです。

> vcpkg --version
vcpkg package management program version 2026-03-04-4b3e4c276b5b87a649e66341e11553e8c577459c

See LICENSE.txt for license information.

独自レジストリの用意の主な手順

以下のステップに分かれた作業を1つずつ実行する必要があります。

  1. vcpkgの独自レジストリ用のgitリポジトリを作成する
  2. vcpkgの独自レジストリに必要なファイルとフォルダーを作成する
  3. 独自レジストリにportを追加する
  4. vcpkgを利用するプロジェクトで独自レジストリを利用するように設定する

手順1. vcpkgの独自レジストリ用のgitリポジトリを作成する

ここでは、独自レジストリの置き場所になるgitリポジトリを用意します。

gitリポジトリはなんでもいいのですがここではGitHubで新しいリポジトリを作成してみます。 ghコマンドならば以下の通りです。 vcpkgから色々なところから参照するならばpublicにしておくのが便利です。

> gh repo create --public --clone my-vcpkg-registry

手順2. vcpkgの独自レジストリに必要なファイルとフォルダーを作成する

ここでは、vcpkgがgitレジストリとして認識できる最小構成を作ります。

vcpkgの独自レジストリとして認識してもらうには、必要なフォルダーとファイルを用意する必要があります。 WSL2, Linux, macOSならばターミナルで、WindowsならばPowerShellで次のコマンドを実行してみてください。

> cd my-vcpkg-registry
> mkdir ports versions
> echo '{"default": {}}' > versions/baseline.json

完了したら次のような構成になっているはず。

> tree . 
.
├── ports
└── versions
    └── baseline.json

手順3. 独自レジストリにportを追加する

ここでは、公式portをコピーして独自レジストリ側で使える形に調整します。

今回はwxWidgetsの日本語対応のために公式レジストリのportを独自レジストリにコピーしてカスタマイズすることにします。

前のコマンドに続いて次のコマンドを実行してみてください。

> cd ..
> git clone --depth 1 https://github.com/microsoft/vcpkg
> cp -pr vcpkg/ports/wxwidgets my-vcpkg-registry/ports/wxwidgets

次にmy-vcpkg-registry/ports/wxwidgets/portfile.cmakeをテキストエディターで開いて、wxUSE_UNICODE_UTF8を有効にするオプションを追加します。

vcpkg_cmake_configure(
    SOURCE_PATH "${SOURCE_PATH}"
    OPTIONS
        ${FEATURE_OPTIONS}
        -DwxUSE_REGEX=sys
        -DwxUSE_ZLIB=sys
        -DwxUSE_EXPAT=sys
        -DwxUSE_LIBJPEG=sys
        -DwxUSE_LIBPNG=sys
        -DwxUSE_LIBTIFF=sys
        -DwxUSE_NANOSVG=sys
        -DwxUSE_LIBWEBP=sys
        -DwxUSE_GLCANVAS=ON
        -DwxUSE_LIBGNOMEVFS=OFF
        -DwxUSE_LIBNOTIFY=OFF
        -DwxUSE_STD_STRING_CONV_IN_WXSTRING=${WXWIDGETS_USE_STL}
        -DwxUSE_STD_CONTAINERS=${WXWIDGETS_USE_STD_CONTAINERS}
        -DwxUSE_UIACTIONSIMULATOR=OFF
        ## [今回の追加分] UTF-8対応を有効にする
        -DwxUSE_UNICODE_UTF8=ON
        ## end
        -DCMAKE_DISABLE_FIND_PACKAGE_GSPELL=ON
        -DCMAKE_DISABLE_FIND_PACKAGE_MSPACK=ON
        -DwxBUILD_INSTALL_RUNTIME_DIR:PATH=bin
        ${OPTIONS}
        "-DPKG_CONFIG_EXECUTABLE=${PKGCONFIG}"

ここまでできたらgitへの登録をしましょう。

> cd my-vcpkg-registry
> git add .
> git commit -m "Add custom wxwidgets port with UTF-8 support"
> git push origin main

最後に、追加したportをvcpkgに認識させるためにversions以下のファイルを更新します。 3行に分けていますが1行でまとめて実行してください。

> vcpkg --x-builtin-ports-root=./ports \
  --x-builtin-registry-versions-dir=./versions \
  x-add-version --all --overwrite-version
warning: In wxwidgets, 3.3.1 is a completely new version, so there should be no "port-version". Remove "port-version" and try again. To skip this check, rerun with --skip-version-format-check .

おっとwarningが出てしまいました。そしてwarningのくせにこれは本来の処理を止めてしまっているため解消する必要があります。

warningが出る原因は「新規バージョンの登録なのにport-versionが付いている」ためで、今回は公式レジストリのportをコピーしてきていることに起因します。 これだとちょっと困るのでメッセージの通り--skip-version-format-checkオプションをつけて再度実行してみてください。

> vcpkg --x-builtin-ports-root=./ports \
    --x-builtin-registry-versions-dir=./versions \
  x-add-version --all --overwrite-version --skip-version-format-check

※本来はport-versionを0にするとか、バージョン番号を変えるとかして新規バージョンの登録にするべきなのですが、今回は公式レジストリのportをコピーしてきているためこのような形で対応しています。

これで独自レジストリの準備は完了です。 最終的な構成は次のようになっています。

> tree .
.
├── ports
│   └── wxwidgets
│       ├── example
│       │   └── CMakeLists.txt
│       ├── fix-libs-export.patch
│       ├── fix-pcre2.patch
│       ├── gtk3-link-libraries.patch
│       ├── install-layout.patch
│       ├── nanosvg-ext-depend.patch
│       ├── portfile.cmake
│       ├── relocatable-wx-config.patch
│       ├── sdl2.patch
│       ├── setup.h.in
│       ├── usage
│       ├── vcpkg-cmake-wrapper.cmake
│       └── vcpkg.json
└── versions
    ├── baseline.json
    └── w-
        └── wxwidgets.json

versionsの中身は次のようになっていますが、ここは基本的にvcpkgコマンドが自動で更新してくれるのであまり気にしなくて大丈夫です。

{
  "default": {
    "wxwidgets": {
      "baseline": "3.3.1",
      "port-version": 1
    }
  }
}

以上で、vcpkgの独自レジストリの準備が完了しました。

手順4. vcpkgを利用するプロジェクトで独自レジストリを利用するように設定する

ここでは、実際のプロジェクト側から独自レジストリを参照する設定を行います。

独自レジストリを利用するには、vcpkgを利用しているプロジェクトのvcpkg.jsonと同じフォルダにvcpkg-configuration.jsonというファイルを作成する必要があります。

詳しくは公式ドキュメントに記載されているのですが、今回は次のような内容で作成してみます。

{
  "default-registry": {
    "kind": "git",
    "baseline": "",
    "repository": "https://github.com/microsoft/vcpkg"
  },
  "registries": [
    {
      "kind": "git",
      "baseline": "",
      "repository": "https://github.com/YOUR-NAME/my-vcpkg-registry",
      "packages": ["wxwidgets"]
    }
  ]
}

default-registryは公式レジストリを指します。

基本的には公式レジストリが提供しているportを利用する

という形になります。

registriesは独自のportを提供するレジストリを登録します。

ここでは先ほど作成した独自レジストリを登録するためにrepositoryに該当のrepositoryのURLを指定します。 packagesには今回定義したportであるwxwidgetsを指定します。 これを記述しないと公式レジストリのwxwidgetsを参照してしまいますので必ず指定する必要があります。

最後にそれぞれのリポジトリのbaselineを指定する必要があります。 baselineはvcpkgのバージョン管理の仕組みの一部でgitのコミットハッシュを指定します。 こうすることで、gitリポジトリが更新されても、ある一定のコミット時点のportのバージョンを安定して利用できます。

※ 公式リポジトリの更新頻度はとても高いので、意図しないバージョンアップを防ぐために独自リポジトリを利用しない場合でもbaselineを指定しておくことを推奨します。

とはいえ、baselineを手動で指定するのは面倒なので、vcpkgコマンドを利用して最新のコミットハッシュを自動で取得してみましょう。

> vcpkg x-update-baseline
updated registry 'https://github.com/microsoft/vcpkg': baseline '' -> 'bba8b52f6dea74159bba855ef00376e588d6ea0a'
updated registry 'https://github.com/YOUR-NAME/my-vcpkg-registry': baseline '' -> '79741be6465f0f99be85f54f2638479cd19467db'

vcpkg-configuration.jsonが次のように更新されていればOKです。

{
  "default-registry": {
    "kind": "git",
    "baseline": "bba8b52f6dea74159bba855ef00376e588d6ea0a",
    "repository": "https://github.com/microsoft/vcpkg"
  },
  "registries": [
    {
      "kind": "git",
      "baseline": "79741be6465f0f99be85f54f2638479cd19467db",
      "repository": "https://github.com/YOUR-NAME/my-vcpkg-registry",
      "packages": ["wxwidgets"]
    }
  ]
}

これで独自レジストリの利用の準備が完了しました。 あとは今まで通りvcpkg.jsonに"wxwidgets"を指定すれば、独自レジストリのportが利用されるようになります。

> vcpkg add port wxwidgets

独自リポジトリを更新したときの注意点

独自リポジトリを更新したときには、利用しているリポジトリでvcpkg x-update-baselineコマンドを実行してbaselineを更新するのを忘れないようにしてください。

上のようにvcpkg x-update-baselineコマンドを実行してもいいのですが、これだと独自リポジトリだけでなく公式リポジトリのbaselineも更新されてしまいます。 そして公式リポジトリの更新頻度は高いので、おそらくvcpkg x-update-baselineコマンドを実行するたびに公式リポジトリのbaselineも更新されてしまうことになります。(※それで困らないならばこれが一番簡単です。)

公式リポジトリのbaselineは更新しないで独自リポジトリのbaselineだけを更新したい場合には手作業で次のような手順で更新することになります。

  1. 独自リポジトリの最新のコミットハッシュを取得する
  2. vcpkg-configuration.jsonの独自リポジトリのbaselineを最新のコミットハッシュに更新する

overlay-portsとの使い分け

ここまで独自レジストリの手順を説明してきましたが、「これってoverlay-portsではだめなの?」と思う方もいるはずです。 どちらでも今回の問題を解消できますが、用途が少し違います。

overlay-portsが向いているケース

overlay-portsは、特定のディレクトリに置いたportをそのまま参照する仕組みです。 vcpkg-configuration.jsonから相対パスで指定できるので、手元ですぐ試したいときにはとても便利です。

  • 1つのリポジトリだけで動作確認したい
  • 一時的に公式portを差し替えて試したい
  • バージョンデータベースやgitレジストリの整備まではしたくない
  • 身内だけで使えればよく一般公開をしたくない

といった場面では、overlay-portsの方が手軽です。

独自レジストリが向いているケース

独自レジストリは設定の手間が少し増える代わりに、継続利用に強いです。

  • 複数マシンで同じport設定を使いたい
  • CI/CDでも同じ設定を再現したい
  • baselineで利用する時点を固定したい
  • 特定のpackageだけを独自版に差し替えたい

「公式レジストリの恩恵は受けつつwxwidgetsだけ独自版に差し替えたい」という用途では、独自レジストリの方が管理しやすいです。 1つ自分用のレジストリをもっておくと便利なのでセットアップの手間をかける価値はあると思います。

おわりに

vcpkgの独自レジストリを用意して公式レジストリと併用する方法について紹介しました。

vcpkg-configuration.jsonにはこれ以外にも色々なオプションがあるのですが、今回紹介した内容が一番管理も利用もしやすいなと思います。 複数マシンやCI/CDでの利用が簡単なのが気に入っています。

  • 上でも書いたファイルシステム内の特定ディレクトリに配置されたportを利用するoverlay-ports
  • gitではなくファイルシステムの特定ディレクトリに配置されたレジストリを利用するファイルシステムリポジトリ

といった設定については公式ドキュメントを参照してみてください。

おまけ

今回作成した手順を元に私が作成したリポジトリがありますのでご参考までに。 もし利用したい奇特な方がいらっしゃれば、forkやコピーも含めてご自由にどうぞ。

toge/my-vcpkg-ports

vcpkgでopencv, wxwidgetsなどを利用しようとするとsegfaultしてしまう

vcpkgは便利ですね。 C++で何かをやろうとするとき、依存関係の管理が面倒ですが、vcpkgを使うと簡単にライブラリをインストールできます。

しかし、最近opencvやwxwidgetsなどをLinuxで利用しようとすると、segmentation faultが発生してしまうことに気づきました。 この原因と対策についてのメモです。

結論

生成される実行ファイルにRPATHが埋め込まれ、実行時のライブラリ探索順でライブラリ混在が起きることが原因です。

RPATHが設定されていると、

  • コンパイル時に参照されたvcpkgのライブラリ
  • 実行時にシステムにインストールされた同名のライブラリ

にバージョンの不一致がある場合に、segmentation faultが発生します。

以下のいずれかの方法で対策できます。

  • patchelfなどを使って生成された実行ファイルからRPATHを削除する (patchelf --remove-rpath xxx)
  • vcpkgのビルドオプションを変更してRPATHを設定しないようにする

発生している問題

簡単に再現できるように、opencvをインストールしてビルドした実行ファイルを生成してみます。

※ ファイルは githubのリポジトリ にも登録してあります。

vcpkg.jsonは次のようにします。

{
  "dependencies": [
    "opencv4"
  ]
}

CMakeLists.txtは次のようにします。 OpenCV::OpenCVとリンクできればいいのですが、ちょっと面倒な定義が必要です。

cmake_minimum_required(VERSION 3.25)
project(test LANGUAGES CXX)

find_package(OpenCV REQUIRED)

add_executable(test test.cpp)
target_link_libraries(test PRIVATE
    ${OpenCV_LIBRARIES}
)
target_include_directories(test PRIVATE
    ${OpenCV_INCLUDE_DIRS}
)

C++ファイルは正直なんでもいいのですが、imreadを呼び出すだけの簡単なものにします。

#include <iostream>

#include "opencv2/opencv.hpp"

int main(int argc, char* argv[]) {
  if (argc < 2) {
    std::cerr << "Usage: " << argv[0] << " <image_path>" << std::endl;
    return 1;
  }
  auto const image_path = argv[1];
  auto const img = cv::imread(image_path);
  if (img.empty()) {
    std::cerr << "Error: Could not open or find the image!: " << image_path << std::endl;
    return 1;
  }
  std::cout << "image size : " << img.size().width << " x " << img.size().height << '\n';
  return 0;
}

で、CMakeLists.txtがあるディレクトリで、次のコマンドを実行してビルドします。

cmake -B build -DCMAKE_TOOLCHAIN_FILE=${VCPKG_ROOT}/scripts/buildsystems/vcpkg.cmake -S .
cmake --build build

ビルドが成功したら、生成された実行ファイルを実行してみます。

./build/test

すると、次のようなエラーが発生します。 ※私はfishを使っているので、エラーの表示が少し異なるかもしれませんが、似たような内容になると思います。

fish: Job 1, 'build/test' terminated by signal SIGSEGV (Address boundary error)

どうしてこうなるのか

gdbでデバッグしてみると、次のようなスタックトレースが表示されます。

> gdb build/test
(gdb) run
Program received signal SIGSEGV, Segmentation fault.
(gdb) bt
#0  0x00007ffff7e432cc in ?? ()
#1  0x00007ffff7fca460 in call_init (l=0x7ffff7f71000, argc=1, argv=0x7fffffffdb48, env=0x7fffffffdb58) at dl-init.c:60
#2  call_init (l=0x7ffff7f71000, argc=1, argv=0x7fffffffdb48, env=0x7fffffffdb58) at dl-init.c:26
#3  0x00007ffff7fca57d in _dl_init (main_map=0x7ffff7ffe2f0, argc=1, argv=0x7fffffffdb48, env=0x7fffffffdb58) at dl-init.c:121
#4  0x00007ffff7fe2ea0 in _dl_start_user () from /lib64/ld-linux-x86-64.so.2
#5  0x0000000000000001 in ?? ()
#6  0x00007fffffffdfa1 in ?? ()
#7  0x0000000000000000 in ?? ()

DL関連の関数でsegmentation faultが発生していることがわかります。

生成された実行ファイルにはRUNPATH(またはRPATH)が設定されているため、実行時の探索順によってはvcpkg側とシステム側の同名ライブラリが混在します。 その結果、ABIの不整合が起きると初期化処理(_dl_init 付近)でsegmentation faultになることがあります。

補足として、Linux動的リンカ(ld.so)ではDT_RPATHとDT_RUNPATHの扱いが異なります。

  • DT_RUNPATH は直接依存(DT_NEEDED)の探索に適用される
  • DT_RPATH は依存ツリーの子ライブラリ探索にも適用される

この違いにより、環境によって「どの時点で混在が起きるか」が変わります。

lddコマンドを使って、生成された実行ファイルがどのライブラリを参照しているかを確認できます。 readelfコマンド(通常はbinutilsに含まれる)で、生成された実行ファイルの動的セクションを確認すると、runpathが設定されていることがわかります。

最後の1行のRUNPATHに、vcpkgのインストールディレクトリが含まれていることがわかります。

> sudo dnf install binutils
> readelf -d build/test

Dynamic section at offset 0x7b0ae0 contains 43 entries:
 タグ        タイプ                       名前/値
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXrandr.so.2]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXcursor.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXcomposite.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXdamage.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXfixes.so.3]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libdbus-1.so.3]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXtst.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXi.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libGL.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libEGL.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libstdc++.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXext.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXrender.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libX11.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libatomic.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libm.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libgcc_s.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libc.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [ld-linux-x86-64.so.2]
 0x000000000000001d (RUNPATH)            ライブラリの runpath: [xxx/build/vcpkg_installed/x64-linux/lib]

解決策

解決策は2つあります。

  • 実行ファイルの生成時にRUNPATH/RPATHを設定しないようにする
  • 生成された実行ファイルからRUNPATH/RPATHを削除する

実行ファイルの生成時にRUNPATH/RPATHを設定しないようにする

対象ターゲットにSKIP_BUILD_RPATHプロパティを設定することで、生成される実行ファイルにRUNPATH/RPATHが設定されないようにできます。

cmake_minimum_required(VERSION 3.25)
project(test LANGUAGES CXX)

find_package(OpenCV REQUIRED)

add_executable(test test.cpp)
target_link_libraries(test PRIVATE
    ${OpenCV_LIBRARIES}
)
target_include_directories(test PRIVATE
    ${OpenCV_INCLUDE_DIRS}
)
# RUNPATH/RPATHを設定しないようにする
set_target_properties(test PROPERTIES SKIP_BUILD_RPATH TRUE)

生成された実行ファイルからRPATHを削除する

patchelfコマンドを使ってRUNPATH/RPATHを削除することで、ライブラリ探索順の影響を避けられ、segmentation faultが解消される場合があります。

ただし、これは「常に安全な修正」ではありません。バイナリがvcpkg側の共有ライブラリを前提としている場合、単純に削除すると今度は起動できなくなる可能性があります。 根本的には、依存ライブラリの供給元(vcpkgかシステムか)を混在させず統一するのが安全です。

> sudo dnf install patchelf
> patchelf --remove-rpath build/test
> build/test
Usage: build/test <image_path>

解消後の確認

どちらの手段を使ってもreadelfコマンドで確認してみるとRUNPATHがなくなっていることがわかります。

> readelf -d build/test

Dynamic section at offset 0x7afb00 contains 42 entries:
 タグ        タイプ                       名前/値
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXrandr.so.2]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXcursor.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXcomposite.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXdamage.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXfixes.so.3]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libdbus-1.so.3]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXtst.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXi.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libGL.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libEGL.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libstdc++.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXext.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libXrender.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libX11.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libatomic.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libm.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libgcc_s.so.1]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [libc.so.6]
 0x0000000000000001 (NEEDED)             共有ライブラリ: [ld-linux-x86-64.so.2]
 0x000000000000000c (INIT)               0x400374
 0x000000000000000d (FINI)               0xa4ba18
 0x0000000000000019 (INIT_ARRAY)         0xb96af8
 0x000000000000001b (INIT_ARRAYSZ)       128 (バイト)
 0x000000000000001a (FINI_ARRAY)         0xb96b78
 0x000000000000001c (FINI_ARRAYSZ)       8 (バイト)
 0x000000006ffffef5 (GNU_HASH)           0xa4c020
 0x0000000000000005 (STRTAB)             0xa4d840
 0x0000000000000006 (SYMTAB)             0xa4c058
 0x000000000000000a (STRSZ)              6860 (バイト)
 0x000000000000000b (SYMENT)             24 (バイト)
 0x0000000000000015 (DEBUG)              0x0
 0x0000000000000003 (PLTGOT)             0xbb0fe8
 0x0000000000000002 (PLTRELSZ)           5400 (バイト)
 0x0000000000000014 (PLTREL)             RELA
 0x0000000000000017 (JMPREL)             0xa52918
 0x0000000000000007 (RELA)               0xa4f780
 0x0000000000000008 (RELASZ)             12696 (バイト)
 0x0000000000000009 (RELAENT)            24 (バイト)
 0x000000006ffffffe (VERNEED)            0xa4f510
 0x000000006fffffff (VERNEEDNUM)         5
 0x000000006ffffff0 (VERSYM)             0xa4f30c
 0x0000000000000000 (NULL)               0x0

まとめ

vcpkgでopencvやwxwidgetsなどを利用しようとすると、生成される実行ファイルに埋め込まれたRPATHと実行時の探索順の組み合わせにより、同名ライブラリの混在が発生し、segmentation faultが起こることがあります。

この問題を解決するには、生成された実行ファイルからRPATHを削除するか、vcpkgのビルドオプションを変更してRPATHを設定しないようにできます。

RPATHのことを知らないと、どうしてこの問題が発生しているのか調査するのも難しいので、メモとしての残しておきます。

unordered_dense 4.7.0で追加された replace_key を使ってみる

unordered_denseの紹介

unordered_denseというライブラリをご存知でしょうか? std::unordered_mapの代替として利用することができ、基本的にstd::unordered_mapより高速に動作し、特定の用途においては沢山あるハッシュマップコンテナの中で最速の性能を出すこともあるハッシュマップコンテナです。

私も以前はmapを利用するシーンでは必ずといっていいほど使っていたのですが、最近は大抵の場合より高速に動作するabseilのabsl::flat_hash_mapを使うことが多くなってしまいました。悲しい。

とはいえ、十分に高速に動作するハッシュマップであることは確かです。 abseilのような大規模なライブラリとは違って簡単に導入できることもあり、オススメのライブラリです。

基本的にstd::unordered_map互換

公式ドキュメントにも記載がある通り、unordered_denseはstd::unordered_mapを差し換える形で利用することができます。

このため、以下のようにusingで別の型名を定義して使っておけば、簡単に実装を差し換えることができます。 ※ abseilのabsl::flat_hash_mapも互換性を維持しているので同じことができます。

#ifdef USE_STD
using hashmap = std::unordered_map<std::string, uint>;
#else
using hashmap = aknl::unordered_dense<std::string, uint>;
#endif

そして高速なJSONシリアライズ・デシリアライズライブラリであるglazeは、std::unordered_map互換のコンテナにも対応しているので、unordered_denseとglazeを使えばいつでも実装を切り替えられるのです。便利。

// 以下の構造体は、hashmapの定義がどちらでもglazeで扱うことができる!
struct test_struct {
  int id;
  std::string name;
  hashmap properties;
};

…完全に横道ですね。失礼しました。本題に戻ります。

unorderd_dense 4.7.0で追加された関数

std::unorder_mapとの互換性あるの最高!

という話をしたにもかかわらず、独自拡張の話にすすみます。

unordered_denseは2025-09にリリースされた4.7.0で replace_key という関数が追加になりました。 名前の通り「キーを置き換える」ための関数です。

「標準ライブラリとの互換性」という価値を捨てる選択をするほど、この関数に価値があるのかを知りたかったので、どういう関数なのかを調べてみようと思いました。

その他のstd::unordered_mapにはない他の独自関数

少し脱線しますが、replace_key以外にもunordered_denseには独自関数が存在します。 実はそれぞれとても価値のある関数たちなので、別のところで紹介できればと思います。

関数名 説明
at_index 内部管理のvalue_typeの配列から要素を取得する
capacity 内部管理のvalue_typeの配列の容量を返す
data 内部管理のvalue_typeの配列を返す
erase_and_shift_down 挿入順序を維持して指定要素を削除する
reinit 指定要素数で内部構造を完全初期化する
shrink_to_fit 内部管理のvalue_typeの配列を実データ分に縮小する
steal 他インスタンスから内部データを移動する std::moveより強力
values value側のデータのビューを返す

replace_keyの紹介

replace_keyは、ハッシュマップのキーを置き換える関数です。 キーに対応している値はそのまま維持する場合に利用します。

// old_keyに対応する値のキーをnew_keyに置き換える
auto const p = hashmap.find(old_key);
if (p != hashmap.end()) {
  hashmap.replace_key(p, new_key);
}

std::unordered_mapの場合はreplace_keyという関数はないので次のように実装する必要があります。

auto node = hashmap.extract(old_key);
if (not node.empty()) {
  node.key() = new_key;
  hashmap.insert(std::move(node));
}

ノードハンドル(extract で取り出したもの)を使ってキーだけ差し替えて戻す、という形です。 replace_keyを使った方がちょっとシンプルになりますね。

replace_keyのメリット

実はstd::unordered_mapでの実装(extract->insert)は効率としてはそれほど悪くはありません。 std::unordered_mapの多くの実装では「値を大きく動かさずにすむ」ように実装しているため、キー置換としてはそこまで悪い手ではありません。

一方で unordered_dense は、内部的に key/value を連続した配列のような形で管理する設計です。 このタイプのコンテナで extractを実施すると、要素の削除がトリガーになって内部配列の詰め替えが起きやすいのです。 特にvalueの移動コストが重い場合や要素数が多い場合に、コストが目立ちやすくなります。

これはunordered_denseの大きな弱点の一つでした。

replace_key はこの弱点をピンポイントに補うための関数で、

  • 要素の削除(=配列の詰め替え)を避ける
  • キーの置換に必要な処理(再ハッシュや再配置など)に寄せる という狙いの関数だと理解できます。

ベンチマーク

実際にどれくらい効率的なのかをベンチマークしてみました。

要素数は10000、キーは重複しないランダムなものにして、keyとvalueの型をintとstd::stringの組み合わせの4パターンで試しています。

それぞれのベンチマークでは以下の5つの方法でキーの置き換えを行っています。

  • 01 : std::mapでextract->insertしたもの
  • 02 : std::flat_mapでfind->erase->emplaceしたもの
  • 03 : std::unordered_mapでextract->insertしたもの
  • 04 : unordered_denseでextract->insertしたもの
  • 05 : unordered_denseでreplace_keyしたもの

ソースコードはこちらになります。 ※ ベンチマークライブラリはceleroを利用しています。

key: int value: intの場合

Group Experiment Prob. Space Samples Iterations Baseline us/Iteration Iterations/sec RAM (bytes)
INT_INT 01_STD_MAP Null 30 10 1.00000 842.70000 1186.66 8380416
INT_INT 02_STD_FLAT_MAP Null 30 10 58.72849 49490.50000 20.21 8753152
INT_INT 03_STD_UNORDERE Null 30 10 0.91053 767.30000 1303.27 8753152
INT_INT 04_UNORDERED_DE Null 30 10 0.22535 189.90000 5265.93 9486336
INT_INT 05_UNORDERED_DE Null 30 10 0.19746 166.40000 6009.62 9486336

ちょっとstd::flat_mapが遅すぎますね。 まあ、これはstd::flat_mapがソートされた配列で管理しているため、要素の削除と挿入にO(n)のコストがかかるためと思います。 現にこれ以降のパターンでもstd::flat_mapは常に遅いです。

replace_keyはextract->insertに比べて10%弱高速に動作しているようです。

key: int value: stringの場合

Group Experiment Prob. Space Samples Iterations Baseline us/Iteration Iterations/sec RAM (bytes)
INT_STRING 01_STD_MAP Null 30 10 1.00000 825.80000 1210.95 8384512
INT_STRING 02_STD_FLAT_MAP Null 30 10 105.90748 87458.40000 11.43 8757248
INT_STRING 03_STD_UNORDERE Null 30 10 0.93170 769.40000 1299.71 8757248
INT_STRING 04_UNORDERED_DE Null 30 10 0.20211 166.90000 5991.61 9490432
INT_STRING 05_UNORDERED_DE Null 30 10 0.20223 167.00000 5988.02 9490432

おっとreplace_keyの方が遅くなってしまいましたね。 ちょっと意外でした。 ただし差はかなり小さく、計測誤差や実行環境要因の可能性もあるため、ここは「少なくとも大きく損しない」くらいの解釈に留めます。

key: string value: intの場合

Group Experiment Prob. Space Samples Iterations Baseline us/Iteration Iterations/sec RAM (bytes)
STRING_INT 01_STD_MAP Null 30 10 1.00000 1315.00000 760.46 8949760
STRING_INT 02_STD_FLAT_MAP Null 30 10 63.75582 83838.90000 11.93 9474048
STRING_INT 03_STD_UNORDERE Null 30 10 0.66570 875.40000 1142.33 9474048
STRING_INT 04_UNORDERED_DE Null 30 10 0.24776 325.80000 3069.37 10129408
STRING_INT 05_UNORDERED_DE Null 30 10 0.24221 318.50000 3139.72 10129408

valueの型がintなので、extract->insertでもそこまで大きなコストにはなっていませんね。 それでもreplace_keyの方が若干高速に動作しています。

key: string value: stringの場合

Group Experiment Prob. Space Samples Iterations Baseline us/Iteration Iterations/sec RAM (bytes)
STRING_STRING 01_STD_MAP Null 30 10 1.00000 1412.10000 708.17 9506816
STRING_STRING 02_STD_FLAT_MAP Null 30 10 122.49210 172971.10000 5.78 9928704
STRING_STRING 03_STD_UNORDERE Null 30 10 0.69436 980.50000 1019.89 9928704
STRING_STRING 04_UNORDERED_DE Null 30 10 0.28589 403.70000 2477.09 11296768
STRING_STRING 05_UNORDERED_DE Null 30 10 0.25366 358.20000 2791.74 11296768

結構10%ぐらいreplace_keyが高速に動作していますね。 value の移動コストが効いているケースほど、狙い通りに効いていそうです。 これならば採用する価値は十分にあると思います。

replace_keyのデメリット

replace_keyは便利な関数ですが、new_keyが既に存在している場合は処理に失敗します。 戻り値の型がstd::pair<iterator, bool>となっており、boolがfalseの場合は置換に失敗したことを示します。

確実にキーを置き換えたい場合は、事前にfindでnew_keyがすでに存在していないかチェックする必要があることを留意してください。。

まとめ

  • unordered_dense は std::unordered_map 互換で差し替えやすく、導入しやすい高速ハッシュマップです。
  • 4.7.0 で追加された replace_key は「値はそのままにキーだけ置換したい」ケースで便利です。
  • unordered_dense のような“連続領域寄り”の設計では、削除を伴う操作が遅くなりやすく、replace_key はそこを避けるための実用的な拡張だと言えます。
  • ベンチマーク的にも、特に value が重いケースでは採用する価値が十分にありそうです。

今後 unordered_dense を使う場面では、キー置換が必要になったらまず replace_key の利用を検討していきたいと思います。

glazeで環境変数から構造体に値を読み取る

glazeで環境変数から構造体に値を読み取る

前回の続きです。 glazeのリフレクション機能がだんだん分かってきたので、すこし実用的なコードを書いてみました。

やりたいこと

集成体の各メンバーに環境変数から値を取得して代入する

という関数を書いてみようと思います。

struct test_struct {
  int number1;
  float number2;
  std::string message;
};

という構造体を定義しているとして、 NUMBER_1, NUMBER_2, MESSAGEという環境変数の値を取得して、対応する型変換をして代入する、というのが期待する動作です。

  1. フィールドの名前を取得する
  2. フィールドの型を確認する
  3. 環境変数値が文字列で取得できるので、変換処理を書いて代入する

というのを全フィールドに対して実装する必要がありますね。 毎回これを書くのはめんどうなのでglazeの機能でできるだけ実装してしまおうという話です。

メンバー名を一覧表示する

前回の投稿のおさらいでメンバーの一覧を取得して表示する関数を作ってみます。 メタ情報あり・なしの両方で一覧表示できるようにしてみます。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int number1;
  float number2;
  std::string message;
};

template<>
struct glz::meta<test_struct> {
  using T = test_struct;
  static constexpr auto value = glz::object(
    "NUMBER_1", &T::number1,
    "NUMBER_2", &T::number2,
    "MESSAGE", &T::message
  );
};

template<typename T, std::size_t IDX = 0>
auto print_members(T const& value) {
  if constexpr (IDX < glz::reflect<T>::size) {
    auto const field_name = glz::reflect<T>::keys[IDX];
    std::cout << IDX << " " << field_name << '\n';
    print_members<T, IDX + 1>(value);
  }
}

auto main([[maybe_unused]] int argc, [[maybe_unused]] char* argv[]) -> int {
  auto value = test_struct{};
  print_members(value);
}

実行結果は以下のとおり。 フィールド名がとれていることが確認できます。

0 NUMBER_1
1 NUMBER_2
2 MESSAGE

泥臭くてすみませんが、再帰関数での実装しか思いつきませんでした。 きっともっと綺麗な方法があるはず。昔の方法しか知らないのです…。

メンバーのサイズを取得した上で0から順に増加させていき、そのインデックスのメンバー情報を取得しています。

メンバーの値も表示する

これも前回の投稿の応用ですね。 メタ情報のあるなしで実装方法が変わるのでif constexprで分岐させています。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int number1;
  float number2;
  std::string message;
};

template<>
struct glz::meta<test_struct> {
  using T = test_struct;
  static constexpr auto value = glz::object(
    "NUMBER_1", &T::number1,
    "NUMBER_2", &T::number2,
    "MESSAGE", &T::message
  );
};

template<typename T, std::size_t IDX = 0>
auto print_members(T const& value) {
  if constexpr (IDX < glz::reflect<T>::size) {
    auto const field_name = glz::reflect<T>::keys[IDX];
    auto const& field_value = [&]() -> decltype(auto) {
        if constexpr (glz::reflectable<T>) {
          // メタ情報がない場合はstd::tupleにしてから取得する
          return glz::get<IDX>(glz::to_tie(value));
        } else {
          // メタ情報がある場合はメタ情報を利用して取得する
          auto& member = glz::get<IDX>(glz::reflect<T>::values);
          return glz::get_member(value, member);
        }
    }();
    std::cout << IDX << " " << field_name << " " << field_value << '\n';

    print_members<T, IDX + 1>(value);
  }
}

auto main([[maybe_unused]] int argc, [[maybe_unused]] char* argv[]) -> int {
  auto value = test_struct{.number1 = 55, .number2 = 33.3f, .message = "Hello", };
  print_members(value);
}

実行結果は以下の通り。 ちゃんと値取れてますね。

0 NUMBER_1 55
1 NUMBER_2 33.3
2 MESSAGE Hello

環境変数から値を読み取って代入する

メンバーの値を取得できるようになったので、今度は逆をやってみます。 フィールド値と同じ名前の環境変数があればそれを読み取って代入する、という関数を書いてみます。

  • 環境変数の取得は std::getenv を使います
  • 文字列から各型への変換は std::from_chars を使います
  • 文字列への変換はstd::from_chars は対応していないので、文字列型の場合は直接代入します

他の型も試したいのでtest_structに文字列メンバーを追加してみます。

#include <iostream>
#include <cstdlib>

#include "glaze/glaze.hpp"

struct test_struct {
  int number1;
  float number2;
  std::string message;
};

template<>
struct glz::meta<test_struct> {
  using T = test_struct;
  static constexpr auto value = glz::object(
    "NUMBER_1", &T::number1,
    "NUMBER_2", &T::number2,
    "MESSAGE", &T::message
  );
};

// print_members関数は前述のコードと同じため省略

namespace internal {

template<typename T, std::size_t IDX>
auto from_env(T& result) {
  if constexpr (IDX < glz::reflect<T>::size) {
    auto const field_name = glz::reflect<T>::keys[IDX];
    if (auto const env = getenv(field_name.data()); env != nullptr) {
      auto& value = [&]() -> decltype(auto) {
        if constexpr (glz::reflectable<T>) {
          // メタ情報がない場合はstd::tupleにしてから取得する
          return glz::get<IDX>(glz::to_tie(result));
        } else {
          // メタ情報がある場合はメタ情報を利用して取得する
          auto& member = glz::get<IDX>(glz::reflect<T>::values);
          return glz::get_member(result, member);
        }
      }();
      // std::from_charsはstd::stringへの変換に対応していないので、std::stringの場合は直接代入する
      if constexpr (std::is_convertible_v<decltype(value), std::string>) {
        value = env;
      } else {
        // TODO: エラーチェックをすること
        std::from_chars(env, env + std::strlen(env), value);
      }
    }
    from_env<T, IDX + 1>(result);
  }
}

}

template<typename T>
auto from_env() {
  T result{};
  internal::from_env<T, 0>(result);
  return result;
}

auto main([[maybe_unused]] int argc, [[maybe_unused]] char* argv[]) -> int {
  auto result = from_env<test_struct>();
  print_members(result);
}

環境変数を設定して実行してみます。

$ NUMBER_1=55 NUMBER_2=33.3 MESSAGE=Hello test_program

実行結果は次の通りです。

0 NUMBER_1 55
1 NUMBER_2 33.3
2 MESSAGE Hello

ちゃんと環境変数から値を読み取って代入できていますね。 glazeのメタ情報だけ定義すれば、あとは関数呼び出し1つで環境変数から構造体に値を読み取って代入できるようになりました。

足りないことはたくさんある

まだまだ足りない点はたくさんありますね。

実装長くなるし、glazeのリフレクションの話からも外れるので、この記事ではここまでとします。

  • エラーハンドリングが全然ない
  • 変換に失敗した場合の処理を書いていない
  • ネストした構造体や配列・ベクターなどのコンテナに対応していない

この実装を拡張しつつ、実用的なコードにしていきたいと思います。 ある程度まとまったら公開したいですね。

(2026-03-31追記) glz-utilの一部機能として公開しました。 ある程度単体テストも通しているのである程度動作するはずです。 github.com

まとめ

最低限のやりたいことは達成できたので良しとします。

  • glazeのリフレクション機能を使うと、構造体のメンバー名や型情報を取得できる
  • 任意の構造体のメンバーの名前と値を取得・表示する関数が書けた
  • メタ情報があれば、メンバーの名前を変更してアクセスすることもできた
  • メンバー名と一致する環境変数から値を取得して、構造体に代入する関数が書けた

glazeを使って構造体への読み書きが簡単にできるようになったので、他のフォーマットにも応用できそうです。 何かのパーサーと組み合わせて使うのも面白そうですね。

glazeのリフレクションで構造体のメンバー情報をとってくる

今月も相変わらずglazeをうまく活用することを考えていました。 今回はglazeのリフレクション機能を利用する話です。

※ この記事では2025-10-22にリリースされたglaze v6.0.1を対象としています。

TL;DR

  • glazeはC++23時代の現時点で現実的なリフレクション機能を外部に向けて提供しています
  • ドキュメントは限定的ですが、テストコードを参照することで大抵の機能が利用できます
  • メタ情報を付与している場合と付与していない場合で処理を分ける必要があるのが注意点です

glazeのリフレクション機能

glazeはC++23までの機能を利用して、集成体に対してリフレクションを実現しています。 集成体であればstd::map, std::setどころかコンセプトを利用することで、互換性のあるサードパーティのコンテナがメンバーの場合にも対応しています。

メタ情報を提供しなくても構造体のフィールドへのアクセスを実現していますし、構造体の外でメタ情報を付与することで、「除外するメンバ」「別名定義」なんかを実現できるようになっています。 対象となる構造体に影響を与えないのがありがたいですね。(個人的に大好物)

glazeのリフレクションを利用する

普段はJSON, CSV, TOMLなんかとの相互変換の裏で利用されているリフレクション機能なのですが、一応単独で利用することができます。 あんまりドキュメント化されてはいないのですが、テストコードからどんな機能があるかを理解することができます。

github.com

glz::reflect<T>周りがキモですね。

構造体のメンバー数を取得する

まずは序の口。メンバー数を取得します。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int32_t int1{};
  int64_t int2{};
};

auto main() -> int {
  std::cout << glz::reflect<test_struct>::size << '\n'; // -> 2
}

メンバー名を取得する

メンバー名の取得にはkeysを利用します。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int32_t int1{};
  int64_t int2{};
};

auto main() -> int {
  for (auto const key : glz::reflect<test_struct>::keys) {
    std::cout << key << '\n';  // -> int1, int2
  }
}

keyはstd::string_viewになっています。

keysはstd::array<std::string_view>なので、範囲外にアクセスしないように気をつけないといけません。 やるとしたらこんな感じでしょうか。

// 範囲外アクセスを避ける例
if constexpr (glz::reflect<test_struct>::size > 0) {
  auto first_key = glz::reflect<test_struct>::keys[0];
}

メンバーの名前を変更する

ここから先はメタ情報を利用します。

アクセスできるメンバーの名前を変更することもできます。 「C++の予約語と一致している外部データ名」とか「区切り文字が-(ハイフン)のフィールド名」なんかとの連携で便利ですね。

下の例ではint1を"class"、int2を"struct"という名前でアクセスできるようになります。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int32_t int1{};
  int64_t int2{};
};

template<>
struct glz::meta<test_struct> {
  using T = test_struct;
  static constexpr auto value = glz::object(
    "class", &T::int1,
    "struct", &T::int2
  );
};

auto main() -> int {
  for (auto const key : glz::reflect<test_struct>::keys) {
    std::cout << key << '\n';  // -> class, struct
  }
}

メンバーを除外する

メタ情報に定義されていないメンバーは、リフレクション対象から外れます。 下の例ではint2が無視されるようになります。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int32_t int1{};
  int64_t int2{};
};

template<>
struct glz::meta<test_struct> {
  using T = test_struct;
  static constexpr auto value = glz::object(
    "class", &T::int1,
  );
};

auto main() -> int {
  for (auto const key : glz::reflect<test_struct>::keys) {
    std::cout << key << '\n';  // -> class
  }
}

メンバーの値にアクセスする (メタ情報がない場合)

メンバーの情報が取れるようになったら値も取りたいところ。 これは一度メンバーをstd::tupleに変換してからアクセスします。 glazeはメンバーの参照をstd::tupleに変換する関数glz::to_tie()を提供してくれているので、これを利用します。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int32_t int1{};
  int64_t int2{};
};

auto main() -> int {
  auto value = test_struct{};
  auto& int1 = glz::get<0>(glz::to_tie(value));
  int1 = 42;

  std::cout << value.int1 << '\n'; // -> 42
}

メンバーの値にアクセスする (メタ情報がある場合)

上の方法ではメタ情報を考慮せず、「素のメンバーの値をそのまま参照」しています。 メタ情報がある場合には、これを考慮するために以下のようにちょっと面倒なことをします。

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int32_t int1{};
  int64_t int2{};
};

template<>
struct glz::meta<test_struct> {
  using T = test_struct;
  static constexpr auto value = glz::object(
    "int2", &T::int2
  );
};

auto main() -> int {
  auto value = test_struct{};
  auto& element = glz::get<0>(glz::reflect<test_struct>::values);
  auto& int2 = glz::get_member(value, element);

  int2 = 42;

  std::cout << value.int2 << '\n'; // -> 42
}

メタ情報ではint2だけの情報を定義しているので、メンバーとしてはint2だけを参照したいですよね。 これを実現するために、glz::reflect<test_struct>::valuesでtest_structの各メンバーへのポインタを取得し、これとtest_structのインスタンスをglz::get_member()に渡すことで、メンバーへの参照を取得しています。

あとは上と一緒ですね。

ちなみにメタ情報は名前の変更が不要な場合には、メンバーのポインタだけを指定することもできます。

template<>
struct glz::meta<test_struct> {
  using T = test_struct;
  static constexpr auto value = glz::object(
    &T::int2
  );
};

どっちの場合でも動くようにする

うまくいったように見えますが、glz::reflect<T>::values はメタ情報が定義されていないとコンパイルエラーになってしまいます。

メタ情報がある場合にはそっちを参照し、メタ情報がない場合は素直にメンバーのリストから取得する

これを実現するためには、glz::reflectable を使ってメタ情報の有無でif constexprすることが考えられます。

glz::reflectable<T> は次のような値になります。 - Tにメタ情報が定義されていない場合: true - Tにメタ情報が定義されている場合: false

#include <iostream>
#include "glaze/glaze.hpp"

struct test_struct {
  int32_t int1{};
  int64_t int2{};
};

auto main() -> int {
  auto value = test_struct{};

  auto& int1 = []<class T>(T& value) -> decltype(auto) {
      if constexpr (glz::reflectable<T>) {
        // メタ情報がない場合はstd::tupleにしてから取得する
        return glz::get<0>(glz::to_tie(value));
      } else {
        // メタ情報がある場合はメタ情報を利用して取得する
        auto& member = glz::get<0>(glz::reflect<T>::values);
        return glz::get_member(value, member);
      }
  }(value);

  int1 = 42;

  std::cout << value.int1 << '\n'; // -> 42
}

test_structにメタ情報を定義すると、if constexprのelse節が採用されるのでメタ情報を意識した処理になります。

色々苦労した点はあるのですが、説明をすると長くなるのと、筆者の能力を越えているため正しい言葉で説明できるか微妙なので箇条書きにだけしておきます。

  • if constexprを利用するためにテンプレート関数にしています
  • 戻り値を参照値として推論してもらうために decltype(auto) を戻り値の型にしています

まとめ

C++23の範囲でかなり柔軟なリフレクションを実現しているglazeのリフレクション機能の紹介をしてみました。 std::variantへの対応や、異なる構造体型のインスタンス間での一括コピーなど、面白い機能が色々あるのですが、今回はここまでにしておきます。

「これを使って何ができるか?」についてはちまちまコードを書いて検証しているので別の記事で紹介できればと思っています。

glazeはTOMLも簡易的ながら読み書きできる

はじめに

普段から使っているライブラリのドキュメントになっていない便利な機能を発見すると嬉しくなります。 今日は普段遣いしているglazeというC++のライブラリでそういう嬉しい体験をしたので紹介します。

TL:DR

  • glazeにはドキュメントはほとんどないが、TOMLの読み書きできる機能があります
  • ただしTOMLの仕様を完全にサポートしてはいません
  • JSONやBEVEのようにメタ情報の付与もまだできません
  • glazeが別フォーマットへの対応が容易にできるように設計されていることを示す実例にもなってます

glazeの紹介

C++使いの皆さん、glazeというライブラリをご存知でしょうか? glazeはC++でJSONを安定して高速に読み書きできるライブラリです。

ばりばりにSIMD命令で高速化したsimdjsonには及びませんが、yyjsonとだいたい同じぐらいの性能を、あまりSIMD命令を利用しないで実現している点が特徴です。

詳しくはjson_performanceを見てください。

そんな高速さを持ちながら、JSON文字列とC++の構造体を直接マッピングでき、メタ情報の提供によって細かく制御できる点が便利です。 個人的には、ここ数年、必須というぐらいに使いまくっているライブラリです。

一方でC++23の機能を積極的に使っているので、組織の方針で使えないケースも多いとは思います。 はやくC++23が普及してほしいものです。

glazeが(公式に)対応しているフォーマット

公式ドキュメントに記載がある通り、glazeは以下のフォーマットに対応しています。

  • JSON
  • CSV
  • BEVE (glaze独自のバイナリフォーマット
  • Stencil/Mustache
  • EETF (Erlang External Term Format))

とはいえ、EETFはErlangのランタイムが必要ですし、Stencil/Mustacheはテンプレートエンジンとしての機能提供なので、実質的には上の3つになるかなと思います。

実はTOMLも読み書きできる

公式なドキュメントには記載がありませんが、glazeは2025年に入ってからTOMLの読み書きもできるようになりました。

  • 書き込みは2025-02-15リリースのv4.4.2〜
  • 読み込みは2025-06-10リリースのv5.4.1〜

他のフォーマットに漏れず、C++の構造体と直接マッピングできるようになっています。

#include <iostream>

#include "glaze/glaze.hpp"
#include "glaze/toml.hpp" // TOML対応のためには必要です

struct my_struct {
  int integer{};
  double real{};
  std::string string{};
};

int main() {
    auto toml_str = std::string{R"(
integer = 387
real = 3.14159
string = "Hello World"
)"};

  my_struct toml_val;
  auto toml_result = glz::read_toml(toml_val, toml_str);

  if (toml_result) {
    std::cout << "TOML parse error: " << glz::format_error(toml_result) << "\n";
  } else {
    std::cout << toml_val.integer << " " << toml_val.real << "\n";
  }
}

とはいえ、TOMLは柔軟な書き方ができるフォーマットなので、glazeがサポートしているのはTOMLの仕様の一部に過ぎません。 例えば、配列やコメントにはまだ対応していません。

#include <iostream>

#include "glaze/glaze.hpp"
#include "glaze/toml.hpp" // TOML対応のためには必要です

struct my_struct {
  int integer{};
  double real{};
  std::string string{};
  std::vector<int> array{};
};

int main() {
    auto toml_str = std::string{R"(
integer = 387
real = 3.14159
string = "Hello World"
array = [
  1,
  2,
  3
]
)"};

  my_struct toml_val;
  auto toml_result = glz::read_toml(toml_val, toml_str);

  // 常に失敗します
  if (toml_result) {
    std::cout << "TOML parse error: " << glz::format_error(toml_result) << "\n";
  } else {
    std::cout << toml_val.integer << " " << toml_val.real << "\n";
  }
}

実行結果:

TOML parse error: parse_number_failure

ちょっと前から実装されている書き込みについては、配列についても対応しているようです。

#include <iostream>

#include "glaze/glaze.hpp"
#include "glaze/toml.hpp" // TOML対応のためには必要です

struct my_struct {
  int integer{};
  double real{};
  std::string string{};
  std::vector<int> array{};
};

int main() {
  my_struct value = {387, 3.14159, "Hello World", {1, 2, 3}};
  auto toml_str = glz::write_toml(value).value_or("error");
  std::cout << toml_str << "\n";
}

実行結果:

integer = 387
real = 3.14159
string = "Hello World"
array = [1, 2, 3]

ちょっと中途半端な実装になっているTOML対応ですが、簡単な設定ファイル用途であればJSONパースのついでに使えるので、便利に使っています。 コメントにだけは対応してほしかったりしますが…今後の実装に期待ですね。

TOML対応はglazeの柔軟性の証明

個人のひいき目かもしれませんが、TOML対応自体は、glazeの設計が柔軟であることの証明にもなっていると思っています。

TOML対応は以下のissueから始まっています。 作者のStephen Berryさんがさらっと実装してくれたようですね。

https://github.com/stephenberry/glaze/issues/1594

issueのコメントにもあるとおり「あとはユーザーが必要に応じて実装してね」という方針で、実装は簡易でglazeのコアの機能を利用しているだけです。

たとえば読み込み処理は1000行以下でこれでリフレクションに対応してくれるのは助かるなぁと思っています。

https://github.com/stephenberry/glaze/blob/v5.7.2/include/glaze/toml/read.hpp

今後の発展に期待がもてるライブラリだなとあらためて思う次第でした。

PATH_MAXを使うと環境によってコンパイルエラーになる

PATH_MAXを使いたいだけなのにエラーになる

はじめに

「ファイルシステムのパスの最大値を取得する」方法として、macOSとLinuxなら定数PATH_MAXを使う方法があります。 MSVCだったらMAX_PATHですね。

しかし、これを使うとエラーが出ることがあります。 これで結構はまってしまったので原因と解決策をまとめておきます。

ことの始まり

最近ちょいちょい色々なところで使われるようになったplutovgの1.3.0リリースを使おうとしたときのことです。 いつも使っている環境では何なく使えたのですが、別途使っているサーバー環境でビルドすると以下のようなエラーが出ました。

PATH_MAX’ undeclared (first use in this function)

発生場所はこちら。

https://github.com/sammycage/plutovg/blob/v1.3.0/source/plutovg-font.c#L1009

同じgccのバージョンを利用しているのに、こんなことが起きるのか?と不思議に思いながら調査を始めた次第です。

PATH_MAXには問題があるので注意

出鼻を挫くようですが、PATH_MAXの値の正しさには問題があります。 最近のLinuxではファイルシステムの実装によって最大パス長が動的に変更することができるため、PATH_MAXが常に正しいとは限らないのです。

https://www.reddit.com/r/C_Programming/comments/ke1hf6/path_max_any_downsides/?show=original

これの代替案はpathconfやfpathconfを使うことなのですが、これは後程話すことにして、今は

Linux環境ではPATH_MAXはあまり信用できない

ということだけ覚えておいてください。

PATH_MAXを使いたい場合のエラー

本題に戻ります。

PATH_MAXを使いたい場合は<limits.h>をインクルードする必要がありますが、includeしても以下のようなエラーが出ることがあります。 ちなみにmacOSでのApple Clangではこの問題は発生しません。

’PATH_MAX’ undeclared (first use in this function)

ちなみにPATH_MAXは<limits.h>で定義されていることになっていますが、実際にはさらにその先のヘッダーで定義されていることが多いです。 私の環境ではlinux/limits.hで定義されていました。(GPL-2.0のコードなので掲載はしません。)

  • linux/limits.hをincludeしているのがbits/local_lim.h
  • bits/local_lim.hをincludeしているのがlimits.h となっています。 そしてlimits.hがbits/local_lim.hをincludeする条件は__USE_POSIXが定義されていることになっています。

つまり__USE_POSIXが定義されていればPATH_MAXが使えるようになるわけです。

問題を発生させる簡単なコード

毎回plutosvgをコンパイルするわけにもいかないので、再現する簡単なコードを用意しました。

#include <stdio.h>

#include <limits.h>

int main() {
  printf("PATH : %d\n", PATH_MAX);
}

コンパイルしてみましょう。

gcc path_max.c

問題なくコンパイルできてしまいます。

では、-std=c11オプションを付けてコンパイルしてみましょう。

gcc -std=c11 path_max.c

でましたエラーメッセージ。 これが今回の事象の再現になります。

path_max.c: In function ‘main’:
path_max.c:6:25: error: 'PATH_MAX' undeclared (first use in this function)
    6 |   printf("PATH : %d\n", PATH_MAX);
      |                         ^~~~~~~~
path_max.c:6:25: note: each undeclared identifier is reported only once for each function it appears in

解決策

強引な解決策

強引に__USE_POSIXを定義してしまう方法があります。 他の部分で色々問題おきそうですが、ひとまずは動かすことはできます。

#include <stdio.h>

#define __USE_POSIX
#include <limits.h>

int main() {
  printf("PATH : %d\n", PATH_MAX);
}

もうすこしまともな解決策

-std=gnu11オプションを付けてコンパイルすると、安全に__USE_POSIXが定義されて、PATH_MAXが使えるようになります。

gcc -std=gnu11 path_max.c

根本的な解決策

冒頭でも描いた通り、PATH_MAXはあまり信用できない変数です。 これの代替として、pathconfやfpathconfを使う方法があります。

ここではpathconfを使う例を示します。

#include <stdio.h>

#include <unistd.h>

int main() {
  int path_max = pathconf(".", _PC_PATH_MAX);
  printf("pathconf : %d\n", path_max);
}

定数ではなくなってしまいますが、これが一番安全な方法だと思います。

まとめ

PATH_MAX一つで結構はまってしまいました。

gccを素で使っているとGNU 拡張が有効になっているので気がつきませんが、-std=c11と明示的に使用言語のバージョンを指定するとgnu拡張が無効になるので__USE_POSIXが定義されなくなり、PATH_MAXが定義されなくなる…というのが背景でした。

PATH_MAXは言語標準の定数ではないので、macOSとLinuxでたまたま同じ名前で提供されているからといって、あまり使わない方が良さそうですね。

ちゃんとやるなら、以下のような使い分けをしたほうが良さそうです。

プラットフォーム 推奨
Windows MAX_PATH
macOS PATH_MAX
Linux pathconfで該当パスを指定して_PC_PATH_MAX

Quillでstd::chronoを書式化しようとしてMissing Codecエラーになる

C++20以降の世界ではstd::chronoを使うのがすっかりあたり前になりつつありますね。ありがたや。

私もstd::chronoの恩恵に預かっていたのですが

std::chronoが提供する型を標準出力やログに出力したい

という用途がでてきて少し嵌ったのでメモしておきます。

fmtlibでは問題なく動く

std::printと同様にfmt::printであればfmt/chrono.hをincludeすることで、{:<format>}と任意の形式で日付・時刻を表示することができます。

#include <chrono>

#include "fmt/chrono.h"

int main() {
  auto now = std::chrono::system_clock::now();
  fmt::print("Time: {:%H:%M:%S}\n", now);
}

実行結果は次のようになります。

Time: 20:10:39.467474536

std::print(C++23以降)でも問題なく動く

C++23に対応していないといけませんが、std::printでも問題なくstd::chronoが使えます。

#include <print>
#include <chrono>

int main() {
  auto now = std::chrono::system_clock::now();
  std::print("Time: {:%H:%M:%S}\n", now);
}

Quillを使う場合に問題が発生してしまう

ところがQuillでは問題がおきてしまいます。

QuillとはC++ロギングライブラリです。
すごく高速に動き、さまざまな出力先をサポートしていて、fmtlibサポートによるフォーマットに対応しているライブラリで、C++でログを出力したい場合に便利です。

ここでのQuillは10.0.1をvcpkgでインストールして使っています。

ソースコードは以下の通り。

#include <chrono>

#include "quill/Backend.h"
#include "quill/Frontend.h"
#include "quill/LogMacros.h"
#include "quill/sinks/ConsoleSink.h"

int main() {
  quill::Backend::start();

  auto logger = quill::Frontend::create_or_get_logger(
    "root", quill::Frontend::create_or_get_sink<quill::ConsoleSink>("root_sink"));

  auto now = std::chrono::system_clock::now();
  LOG_INFO(logger, "Time: {:%H:%M:%S}\n", now);
}

悲しい。 けどちゃんとエラーメッセージが出てくれるのありがたい。

blog-2025-08-25/03_quill_error.cpp:13:3:   required from here
   13 |   LOG_INFO(logger, "Time: {:%H:%M:%S}\n", now);
      |   ^
blog-2025-08-25/build/vcpkg_installed/x64-linux/include/quill/core/Codec.h:64:5: エラー: static assertion failed: 
+------------------------------------------------------------------------------+
|                       Missing Codec for Type 'Arg'                           |
+------------------------------------------------------------------------------+

Error: A codec for the specified type 'Arg' is not available.

Possible solutions:
1. If Arg is an STL type:
   - Ensure you have included the necessary headers for the specific STL type you are using from the quill/std folder.

2. If Arg is a user-defined type:
   - Use either 'DeferredFormatCodec' or 'DirectFormatCodec'.
   - Define a custom Codec for your type.
   - Consider converting the value to a string before logging.

Note: The specific type of 'Arg' can be found in the compiler error message.
      Look for the instantiation of 'codec_not_found_for_type<Arg>' in the error output.
      The compiler should indicate what type 'Arg' represents in this instance.

For more information see https://quillcpp.readthedocs.io/en/latest/cheat_sheet.html

丁寧なエラーメッセージの通り「std::chrono::time_pointに対応するquill::Codecがない」のが原因ですね。

quill::Codecの定義は以下の通り。

/** typename = void for specializations with enable_if **/
template <typename Arg, typename = void>
struct Codec
{
  /***/
  QUILL_NODISCARD QUILL_ATTRIBUTE_HOT static size_t compute_encoded_size(
    QUILL_MAYBE_UNUSED detail::SizeCacheVector& conditional_arg_size_cache, QUILL_MAYBE_UNUSED Arg const& arg) noexcept
  {

専用のヘッダーをインクルードすると解決

ちゃんと公式ドキュメントに解決策がのってました。 quillcpp.readthedocs.io

タイトルにSTLって書いてありますが、std::chrono関連も対応するヘッダー(quill/std/Chrono.h)を明示的にインクルードすれば良いとのこと。

- #include "quill/sinks/ConsoleSink.h"
+ #include "quill/sinks/ConsoleSink.h"
+ #include "quill/std/Chrono.h"

念のため適用したコードは以下の通り。

#include <chrono>

#include "quill/Backend.h"
#include "quill/Frontend.h"
#include "quill/LogMacros.h"
#include "quill/sinks/ConsoleSink.h"
#include "quill/std/Chrono.h"

int main() {
  quill::Backend::start();

  auto logger = quill::Frontend::create_or_get_logger(
    "root", quill::Frontend::create_or_get_sink<quill::ConsoleSink>("root_sink"));

  auto now = std::chrono::system_clock::now();
  LOG_INFO(logger, "Time: {:%H:%M:%S}\n", now);
}

この1行追加だけで、うまく動くようになりました。
公式ドキュメント読むの大事ですね。

12:02:35.870619739 [3609912] 04_quill.cpp:14              LOG_INFO      root         Time: 03:02:35.870619654

ちなみにquill/std/Chrono.hにはquill::Codecの特殊化が定義されています。

template <template <typename...> class ChronoType, typename TimeSpec, typename DurationType>
struct Codec<ChronoType<TimeSpec, DurationType>,
             std::enable_if_t<std::disjunction_v<std::is_same<ChronoType<TimeSpec, DurationType>, std::chrono::time_point<TimeSpec, DurationType>>,
                                                 std::is_same<ChronoType<TimeSpec, DurationType>, std::chrono::duration<TimeSpec, DurationType>>>>>
  : DeferredFormatCodec<ChronoType<TimeSpec, DurationType>>
{
};

DeferredFormatCodecを継承しているので、fmtlibのフォーマット指定子がそのまま使えるようになっています。
DeferredFormatCodecでは文字列へのフォーマットは別スレッドのバックエンドでやってくれるのでメインスレッドの負荷はほとんどありません。ありがたい。

quill/std以下のヘッダー一覧

quill/std/Chrono.h以外にもquill/std以下にはたくさんのヘッダーがあって、色々な型に対応しています。

quill/include/quill/std at master · odygrd/quill · GitHub

ヘッダー 対応する型
Array.h std::array, charの配列
Chrono.h std::chrono::time_point, std::chrono::duration
Deque.h std::deque
FilesystemPath.h std::filesystem::path
ForwardList.h std::forward_list
List.h std::list
Map.h std::map, std::multimap
Optional.h std::optional
Pair.h std::pair
Set.h std::set, std::multiset
Tuple.h std::tuple
UnorderedMap.h std::unordered_map, std::unordered_multimap
UnorderedSet.h std::unordered_set, unordered_multiset
Vector.h std::vector
WideString.h std::wstring, wchar_tの配列

ちなみにstd::unordered_mapだとこんな感じになります。

#include <unordered_map>

#include "quill/Backend.h"
#include "quill/Frontend.h"
#include "quill/LogMacros.h"
#include "quill/sinks/ConsoleSink.h"
#include "quill/std/UnorderedMap.h"

int main() {
  quill::Backend::start();

  auto logger = quill::Frontend::create_or_get_logger(
    "root", quill::Frontend::create_or_get_sink<quill::ConsoleSink>("root_sink"));

  auto value = std::unordered_map<int, std::string>{{1, "one"}, {2, "two"}, {3, "three"}};

  LOG_INFO(logger, "unordered_map: {}\n", value);
}

実行結果は以下の通り。 ちゃんと中身が表示されてますね。便利。

11:58:29.260206994 [3592695] 05_unordered_map.cpp:20    LOG_INFO      root         unordered_map: {1: "one", 2: "two", 3: "three"}

まとめ

Missing Codec for Type 'Arg'(std::chrono::time_point)というコンパイルエラーは、対応するquill::Codecが未定義なのが原因です。
対応するquill::Codecを定義しているquill/std/Chrono.hをインクルードすることで解決できます。

std::chrono以外でも必要な型に対応するquill/std/<Header>.hを追加でincludeすることで、追加実装をすることなくQuillでログ出力できるようになります。

補足

ソースコードとvcpkg.json, CMakeLists.txtなどについては以下に登録してあります。 github.com

C++でURLを正規化する、リダイレクト先のURLを取得する

前提

スクレイピングをC++で実装していると、URLの正規化がしたくなることがあります。

相対的なPATHだけがhref属性に指定されている時に、https://www.example.com/a/b/../c/d/index.htmlみたいなURLをログに出すより、https://www.example.com/a/c/d/index.htmlと表示したいよね、みたいな要望です。

今までは自前で実装したり、std::filesystemの力を借りたりとかしていたのですが、できればちゃんとWHATWG仕様に準拠した正規化をしたいところ。 これを実現することができるライブラリがあったので紹介です。

結論

ada-url/adaを使いましょう。

ただadaではリダイレクト先のURLまでは分かりません。 その用途ではlibcurlかcprを利用するのがおすすめです。

  • libcurlならお手軽に取得できます
  • cprはlibcurlに追加でインストールが必要ですが、少し簡潔に記載できます

ada-url/adaで正規化する

ada-url/adaはWHATWG仕様に準拠したURLのパースを高速に実現するライブラリです。 国際化ドメイン名のためにpunycodeへの対応もしてくれていて優秀です。 github.com

Apache-2.0かMITライセンスで利用できるので、たいていの場合問題なく利用できるはず。

明確な正規化のメソッドはないのですが、パース結果が正規化したURLになっています。

#include <iostream>

#include "ada.h"

int main() {
  auto const raw_url = "HttPs://Example.com:80/a/../b/./c?x=1#Fragment";
  auto const url = ada::parse(raw_url);
  if (not url) {
    std::cerr << "invalid url\n";
    return 1;
  }
  std::cout << url->get_href() << '\n'; // -> http://example.com/b/c?x=1#Fragment
  return 0;
}

高速に動作するし、仕様準拠だしで、安心して使えます。おすすめ。

リダイレクト先のURLを取得する

リンクのURLがリダイレクトされて最終的にまったく別のURLになっている場合があります。 これもできれば最終的なURLを取得したいところ。

この用途では通信をしないada-url/adaは利用できないので、http/httpsクライアントライブラリを利用します。

libcurlを利用する方法

HTTP関連なら何でもできる、安定のlibcurl。

#include <iostream>

#include "curl/curl.h"

int main() {
  auto curl = curl_easy_init();

  curl_easy_setopt(curl, CURLOPT_URL, "https://yahoo.com/");
  // リダクレクト先まで辿っていく 
  curl_easy_setopt(curl, CURLOPT_FOLLOWLOCATION, 1L);
  // BODYの受信はしない
  curl_easy_setopt(curl, CURLOPT_NOBODY, 1L);

  // リクエスト送信
  curl_easy_perform(curl);

  // リダクレクト先のURLを取得
  char* final_url = nullptr;
  curl_easy_getinfo(curl, CURLINFO_EFFECTIVE_URL, &final_url);
  if (final_url) {
    std::cout << final_url << '\n'; // -> https://www.yahoo.com/
  }
  curl_easy_cleanup(curl);
  return 0;
}

cprを利用する方法

C++っぽく書きたいのならばcprを使うとシンプルに書けます。
CURLOPT_NOBODYを手軽に指定できるPrepareHead()を利用しています。

#include <iostream>

#include "cpr/cpr.h"

int main() {
  auto session = cpr::Session{};
  session.SetUrl(cpr::Url{"http://yahoo.com"});
  session.PrepareHead();
  auto const res = session.Head();

  std::cout << res.url.str() << '\n'; // -> https://www.yahoo.com/

  return 0;
}

cpp-httplibでもできるはずなのですが…

cpp-httplibでもここまで手軽ではないものの、status 301, 302をたどっていけば取れるはず。 私の環境では例でつかっているhttp://yahoo.comへのアクセスが不安定だったので断念しました。

何か変な挙動なので、どこかで追試してみたい。